멀티 GPU 스케일링: GPU 1개와 2개가 렌더링에 미치는 실제 영향 (2026년 벤치마크)
개요
소개
요약: 두 번째 GPU를 추가해도 렌더 속도가 두 배가 되는 경우는 드물며, 그 효과는 렌더링 엔진에 따라 달라집니다. 듀얼 RTX 5090 노드에서 처리량 중심 벤치마크(V-Ray, Octane)는 2.00x에 근접하게 스케일링되었지만, 렌더 시간 기반 엔진은 그보다 낮았습니다(Cycles 1.31x~1.59x, Redshift 1.68x). 렌더당 고정 오버헤드가 두 번째 카드로 가속할 수 있는 부분을 갉아먹기 때문입니다. GPU 두 장은 한 대의 머신에서 실질적인 상한선이며, 그 이상의 속도는 한 박스에 카드를 더 쌓는 것이 아니라 더 많은 머신에서 더 많은 프레임을 실행하는 데서 나옵니다.
두 번째 GPU를 추가한다고 해서 렌더 속도가 두 배로 빨라지지는 않습니다. 말로 하면 당연하게 들리지만, 실제로는 카드 두 장이면 속도도 두 배라는 가정 아래 많은 하드웨어 구매 결정이 이루어지고 있습니다. 2026년 6월, 저희는 듀얼 RTX 5090 노드 한 대를 대상으로 4종의 렌더링 엔진과 7가지 씬·벤치마크 조합에서 GPU 1개에서 2개로 늘렸을 때 실제로 어떤 일이 벌어지는지 측정했습니다.
짧게 말하면, 결과는 엔진과 씬에 따라 달라집니다. 처리량 중심 벤치마크(V-Ray, Octane)는 거의 완벽하게 2x에 가깝게 스케일링되었습니다. 렌더 시간 기반 엔진(Cycles, Redshift)은 그보다 낮았고, 렌더에서 고정 오버헤드가 차지하는 비중이 클수록 두 번째 카드의 도움도 줄어들었습니다. 이 글에서는 수치를 하나씩 살펴보고, 곡선이 그런 형태를 띠는 이유를 설명하며, 어디까지가 한계인지도 명확히 짚겠습니다. 카드 두 장은 단일 머신에서의 상한선입니다. 그 이상은 이 구성의 더 큰 버전이 아니라 완전히 다른 아키텍처입니다.
이 글은 하드웨어·벤치마크 중심의 내용이라 GPU에 초점이 맞춰져 있습니다. 다만 먼저 말씀드리자면, 저희 렌더팜에서 실행되는 작업 중 GPU는 소수이며 대부분의 프로덕션 작업은 여전히 CPU 렌더링(CPU 기반 V-Ray, Corona, Arnold)입니다. 하지만 "두 번째 GPU가 그만한 가치가 있는가?"라는 질문을 받는다면, 마케팅 멘트가 아닌 실측 수치를 제공해야 합니다. 아래에 그 수치를 정리했습니다.
테스트 방법 (그리고 이 수치가 아닌 것)
테스트 노드는 RTX 5090 두 장을 장착한 Windows 11 Pro 환경에서 NVIDIA 드라이버 596.36으로 실행되었습니다. 이 글의 모든 비율은 동일한 노드에서 동일한 드라이버, 동일한 소프트웨어 버전으로 카드 1개와 2개를 비교한 것이므로, 두 실행 사이에 다른 조건은 전혀 바뀌지 않았습니다.
모든 씬은 벤더 표준 벤치마크를 사용했습니다. Blender의 Open Data 씬(bmw27, classroom, junkshop), Redshift용 Maxon의 "Vultures" 씬, Chaos V-Ray Benchmark 6.00.02, 그리고 OctaneBench 2025.2.1입니다. 실제 고객 프로젝트나 프로덕션 에셋은 사용하지 않았습니다. 이 데이터셋에는 프레임당 소요 시간, 프레임당 비용, 전기 요금 관련 수치가 포함되지 않으므로, 해당 수치는 공개하지 않으며 임의로 만들어내지도 않습니다.
Cycles 행을 해석할 때 알아두어야 할 방법론적 사항이 하나 있습니다. Blender Cycles(4.5 LTS, OptiX)는 200% 해상도로 실행했습니다. Open Data 기본값보다 높게 설정한 이유는, 렌더가 충분히 오래 지속되어 신뢰할 수 있는 안정적인 스케일링 비율을 측정하기 위해서입니다. 따라서 저희의 Cycles 원시 시간은 공개 Open Data 점수와 비교할 수 없습니다. 리더보드가 아닌 스케일링 측정을 위해 조정된 값입니다. Cycles와 Redshift는 렌더 시간(초, 낮을수록 좋음; 3회 실행의 중앙값)으로 측정되고, V-Ray와 Octane은 벤치마크 점수(vpaths 또는 OctaneBench 포인트, 높을수록 좋음)로 측정됩니다. 두 지표 유형은 서로 다르므로 절대 수치는 엔진 간에 비교할 수 없으며, 동일 엔진 내 스케일링 비율만이 사과와 사과를 비교하는 셈입니다.
핵심 결과: 엔진별 1x~2x 스케일링
아래는 엔진과 씬별로, 동일한 두 번째 RTX 5090이 실제로 어떤 효과를 가져오는지 보여주는 핵심 데이터입니다.
| 엔진 | 씬 | RTX 5090 1개 | RTX 5090 2개 | 스케일링 |
|---|---|---|---|---|
| Cycles | bmw27 | 49.45초 | 32.06초 | 1.54x |
| Cycles | classroom | 23.09초 | 14.54초 | 1.59x |
| Cycles | junkshop | 19.71초 | 15.00초 | 1.31x |
| Redshift | Vultures | 57초 | 34초 | 1.68x |
| V-Ray GPU (CUDA) | 벤치마크 | 11,051 vpaths | 21,728 vpaths | 1.97x |
| V-Ray GPU (RTX) | 벤치마크 | 15,333 vpaths | 30,641 vpaths | 2.00x |
| Octane | OctaneBench 스위트 | 1,690.78 | 3,380.72 | 2.00x |
위에서 아래로 읽으면 뚜렷한 구분이 보입니다. V-Ray와 Octane은 2.00x 또는 그에 근접한 값으로, 두 번째 GPU가 출력을 거의 두 배로 높입니다. Cycles는 1.31x에서 1.59x 사이에 분포합니다. Redshift는 1.68x입니다.
"두 번째 GPU를 추가하면 속도가 두 배가 되나요?"라는 질문에는 무엇을 렌더링하느냐에 따라 세 가지 서로 다른 솔직한 답변이 있습니다. V-Ray와 Octane에서는 사실상 그렇습니다. Cycles에서는 대략 1.3x~1.6x 향상입니다. Redshift에서는 그 중간 어딘가입니다. 단일 배율로 모든 렌더링을 설명할 수 있다고 말하는 사람은 실제로 측정해보지 않은 것입니다.
처리량 엔진이 렌더 시간 엔진보다 스케일링이 좋은 이유
이 패턴은 무작위가 아닙니다. 각 벤치마크가 시간을 어떻게 사용하는지에서 비롯됩니다. V-Ray Benchmark와 OctaneBench는 처리량 테스트입니다. 사용 가능한 컴퓨팅 자원 전체에 작업을 쏟아붓고 점수를 보고하는 방식이며, 씬 로딩, 가속 구조 빌드, 장치 초기화 등의 고정 설정 비용은 전체 실행 시간의 극히 작은 부분을 차지합니다. 두 번째 카드를 추가하면 추가된 실리콘 거의 전부가 유효한 작업에 투입되어 2x에 근접한 결과가 나옵니다. V-Ray RTX 결과가 정확히 2.00x를 기록한 것은, 오버헤드가 사실상 노이즈 수준인 작업에서 예상할 수 있는 정확한 결과입니다.
렌더 시간 엔진은 다르게 작동합니다. Cycles나 Redshift 렌더를 벽시계 시간(초)으로 측정하면 전체 작업을 타이밍하는 셈입니다. 모든 작업에는 병렬화되지 않는 고정 오버헤드가 있습니다. 씬 파싱, BVH/가속 구조 빌드, 커널 컴파일 및 워밍업, 장치 조율, 최종 픽셀 병합 등이 여기에 해당합니다. 두 번째 GPU는 카드 간에 실제로 분할 가능한 부분의 속도를 높입니다. 고정된 부분에는 아무런 영향을 주지 않습니다. 전체 렌더 시간에서 고정 오버헤드가 차지하는 비율이 클수록 스케일링은 2x에서 더 멀어집니다.
각 렌더에서 고정 오버헤드가 차지하는 비중
씬별 두 개의 측정값을 이용하면 이 고정 부분을 직접 추정할 수 있습니다. 카드 1개에서 렌더가 T1초, 카드 2개에서 T2초 걸리고 분할 가능한 부분만 빨라진다고 가정하면, 고정 부분은 대략 2 × T2 − T1이 됩니다. 이는 프로파일러로 측정한 값이 아니라 두 지점만으로 계산한 단순 추정치이지만, 스케일링 수치와 잘 맞아떨어집니다.
| 씬 | 카드 1개 | 카드 2개 | 추정 고정 부분 | 카드 1개 렌더 대비 비중 |
|---|---|---|---|---|
| Cycles junkshop | 19.71초 | 15.00초 | 약 10.3초 | 약 52% |
| Cycles bmw27 | 49.45초 | 32.06초 | 약 14.7초 | 약 30% |
| Cycles classroom | 23.09초 | 14.54초 | 약 6.0초 | 약 26% |
| Redshift Vultures | 57초 | 34초 | 약 11초 | 약 19% |
Cycles junkshop(1.31x)이 Cycles classroom(1.59x)보다 스케일링이 낮은 것도 이 때문입니다. junkshop 렌더의 대략 절반은 두 번째 카드가 손댈 수 없는 작업인 반면, classroom은 대부분의 시간을 분할 가능한 부분에 씁니다. 동일한 엔진, 동일한 하드웨어에서 씬이 두 번째 카드의 효과를 결정합니다.
이는 더 빠른 하드웨어에 대해서도 실용적인 시사점을 줍니다. 더 빠른 카드는 렌더의 분할 가능한 부분을 단축하지만, 고정 부분은 초 단위로 거의 그대로 유지됩니다. 따라서 카드 1개 렌더가 이미 빠를수록 고정 부분이 차지하는 비중은 더 커지고, 두 번째 카드가 비례적으로 더할 수 있는 몫은 줄어듭니다. 두 번째 카드는 여전히 렌더를 더 빠르게 만들지만, 분할할 수 있는 느린 작업이 얼마 남지 않았을 때는 깔끔한 2x를 내지 못할 뿐입니다. 동일한 카드를 쌓으면 선형적인 수익을 기대할 수 있다고 생각하며 비용을 투자하기 전에 반드시 알아두어야 할 사실입니다.
노드당 상한선은 GPU 2개, 그리고 그것으로 충분한 이유
여기서 명확한 선을 그어야 합니다. 대부분의 멀티 GPU 콘텐츠가 조용히 넘어가는 부분이기 때문입니다. 이 벤치마크에 사용된 노드는 GPU 2개를 장착하고 있으며, 저희 렌더팜의 다른 GPU 노드도 마찬가지입니다. 카드 두 장이 노드당 상한선입니다. 4x나 8x 단일 노드 스케일링 곡선은 보여드리지 않겠습니다. 저희가 운용하지 않는 구성이며, 그런 것처럼 암시하지도 않겠습니다.
단일 프레임에서 GPU 두 장 이상을 사용하려면 멀티 노드 분산 렌더링이 필요합니다. 하나의 이미지를 여러 머신에 나누어 처리하는 방식으로, 그에 따른 네트워크 조율, 버킷/타일 관리, 오버헤드가 수반됩니다. 이것은 카드 두 장짜리 박스의 더 큰 버전이 아니라 완전히 별개의 아키텍처입니다. 현재 단일 프레임에 대해서는 제공하지 않으며, "출시 예정" 기능으로 날짜를 달아 언급하지도 않겠습니다.
그리고 대부분의 프로덕션 작업에서는 GPU 두 장 상한선이 실제 제약이 되지 않습니다. 가장 먼저 걸리는 제약은 거의 언제나 카드 수가 아닌 VRAM입니다. 32 GB에 맞지 않는 씬은 GPU를 몇 장 투입해도 렌더되지 않으며, 이는 완전히 다른 문제입니다(복잡한 씬을 위한 RTX 5090 VRAM 한계 글에서 다룹니다).
렌더팜이 한 대의 머신을 넘어서 스케일링하는 방법: 카드가 아닌 프레임
이것이 내면화할 가치가 있는 핵심 구분입니다. "더 많은 하드웨어에서 더 빠르게 렌더한다"는 말에는 완전히 다른 두 가지 의미가 있습니다.
- 하나의 프레임을 여러 GPU 또는 머신에 분할(타일/버킷 분산 렌더링). 카드 두 장 규모에서 1x~2x 수치가 측정하는 것이 바로 이것입니다. 데이터에서 보듯이 렌더 시간 기반 엔진에서는 고정된 렌더당 오버헤드 때문에 수익 체감이 빠르게 나타나며, 머신을 추가할수록 조율 비용만 늘어납니다.
- 많은 프레임을 여러 머신에 분산(프레임 병렬 렌더링). 각 머신이 전체 프레임 하나를 독립적으로 렌더링하며, 애니메이션의 프레임들이 병렬로 분배됩니다. 맞서야 할 단일 프레임 조율 오버헤드가 없으므로 깔끔하게 스케일링됩니다.
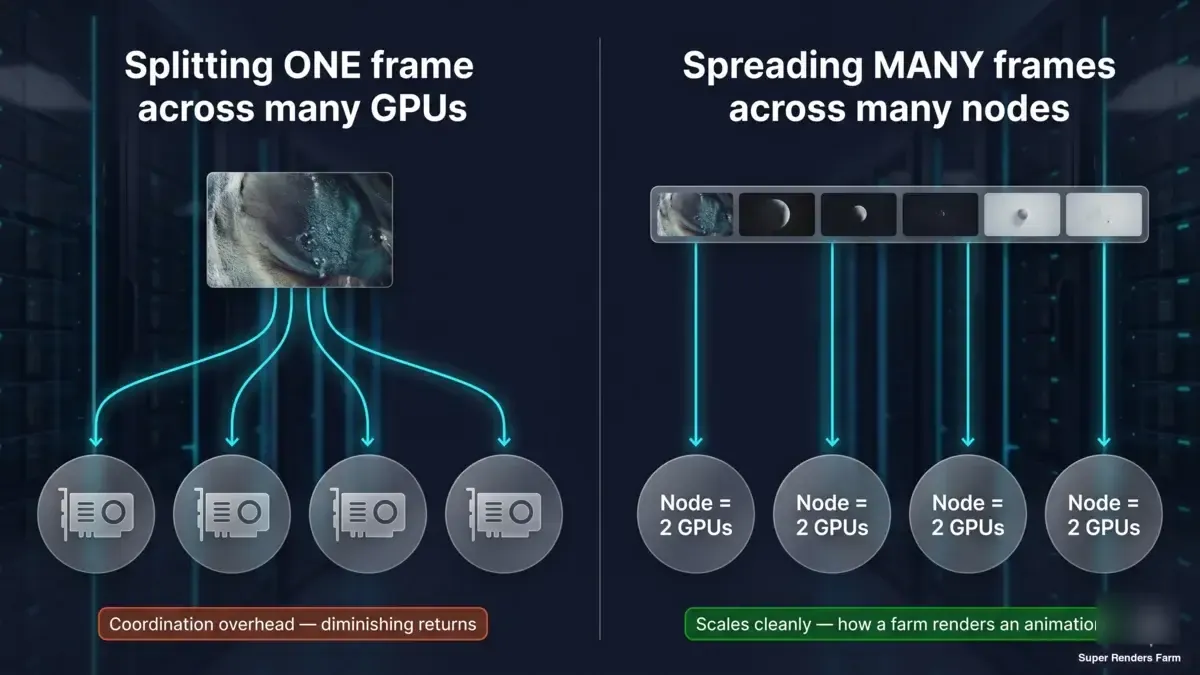 2패널 개념 다이어그램: 하나의 프레임을 여러 GPU에 분할하면 조율 오버헤드와 수익 체감이 발생하는 반면, 여러 개의 전체 프레임을 각각 독립된 머신에서 병렬로 렌더링하면 깔끔하게 스케일링됨
저희 렌더팜에서 CPU 애니메이션은 두 번째 방식으로 렌더링됩니다. 프레임이 여러 대의 CPU 머신에 동시에 분산됩니다. GPU 애니메이션도 동일한 방식으로, 여유가 있는 RTX 5090 카드에 걸쳐 분산됩니다. 다만 저희 GPU 플릿은 규모가 더 작기 때문에 GPU 작업은 CPU 작업보다 더 적은 수의 머신에 분산됩니다. 각 프레임은 여전히 여기서 측정한 카드당 속도와 씬 오버헤드로 렌더링됩니다. 과금은 카드 시간당(card-hour) 기준이므로 작업을 분산시켜도 주로 대기 시간만 바뀌며, 카드가 추가될 때마다 씬을 한 번씩 로드하므로 짧은 작업에서는 총 비용이 다소 늘어날 수 있습니다.
따라서 멀티 GPU에 대한 솔직한 이야기는 마케팅 버전보다 좁습니다. 한 머신에 카드 두 장을 넣으면 실제로 측정 가능한 향상을 얻습니다. V-Ray와 Octane에서는 2x에 가깝고, Cycles와 Redshift에서는 더 완만합니다. 그 이상에서는 답이 "박스에 카드를 더 쌓는 것"이 아니라 "더 많은 머신에서 더 많은 프레임을 실행하는 것"입니다.
렌더링 방식을 선택할 때 이것이 의미하는 바
워크스테이션에서 카드 1개와 2개 중 어느 것을 선택할지 결정할 때는, 주로 사용하는 엔진이 판단 기준이 되어야 합니다. V-Ray나 Octane 사용자는 거의 완전한 두 배의 효과를 얻으므로 두 번째 카드는 정당화하기 쉽습니다. Cycles나 Redshift 사용자는 이런 씬 기준으로 대략 1.3x~1.7x 향상을 기대해야 하며, 더 빠른 단일 카드가 더 나은 선택인지 저울질해 볼 필요가 있습니다. 로컬에서 렌더할지 렌더팜에 맡길지 결정할 때는, 렌더팜의 장점이 다수 프레임에 대한 병렬 처리량이지 마법 같은 단일 프레임 배수가 아니라는 점을 기억하십시오. 단일 히어로 스틸 프레임은 비슷한 워크스테이션보다 렌더팜에서 극적으로 빨라지지 않습니다.
풀 매니지드와 DIY의 트레이드오프(드라이버, 라이선스, 노드 구성을 누가 처리하는지)에 대한 맥락은 저희의 풀 매니지드 렌더팜 대 DIY 렌더팜 비교 가이드를 참고하십시오. 저희 렌더팜에서는 렌더링 엔진 라이선스(V-Ray, Redshift, Octane)가 렌더링 요금에 포함되어 있으며, 노드 구성과 드라이버도 대신 관리해 드리므로 직접 조립하거나 조정할 필요가 없습니다. 1.68x 스케일링 수치가 나온 Redshift-on-Cinema-4D 쪽에 대해서는 Cinema 4D용 Redshift 렌더팜 가이드를 참고하십시오.
이 글의 측정값은 의도적으로 과장 없이 제시했습니다. 두 번째 GPU는 실제 효과가 있는 레버지만 명확한 한계도 있습니다. 시간에서 고정 오버헤드가 차지하는 비중이 클수록 얻는 이득이 적으며, 한 머신을 넘어서는 속도는 카드를 쌓는 이야기가 아니라 프레임 분배 이야기입니다. 자신의 작업에 어떤 레버가 적용되는지 아는 것이 결정의 대부분을 차지합니다.
이 배율들을 바탕으로 작업 비용을 산정하려면 현재 렌더팜 가격을 확인하거나 프레임당 비용 벤치마킹 방법론을 참고하십시오. CPU 쪽 하드웨어 비교는 저희의 클라우드 렌더링용 Cinebench 점수나 V-Ray Benchmark 가이드를 참고하십시오. 단일 카드 RTX 5090의 동작에 대해서는 저희의 RTX 5090 GPU 클라우드 렌더링 성능 글을 참고하십시오.
FAQ
Q: 두 번째 GPU를 추가하면 렌더링 속도가 두 배가 됩니까? A: 대체로 그렇지 않습니다. 저희의 2026년 듀얼 RTX 5090 노드 벤치마크에서 V-Ray와 Octane 같은 처리량 엔진은 동일한 두 번째 카드로 2.00x에 근접한 스케일링을 보였지만, 렌더 시간 기반 엔진은 더 낮게 나타났습니다. Cycles는 1.31x에서 1.59x 사이, Redshift는 1.68x를 기록했습니다. 향상 폭은 엔진과 씬에 따라 달라지는데, 모든 렌더에는 두 번째 카드로 가속할 수 없는 고정 오버헤드가 있기 때문입니다.
Q: 어떤 렌더는 다른 렌더보다 두 번째 GPU로부터 얻는 이득이 적은 이유는 무엇입니까? A: 모든 렌더에는 카드가 1개든 2개든 거의 동일한 시간이 걸리는 고정 작업(씬 파싱, 가속 구조 빌드, 커널 워밍업)이 포함되어 있기 때문입니다. 저희의 카드 1개 및 2개 측정값을 기준으로, 이 고정 부분은 Redshift Vultures 렌더에서는 약 19%, Cycles junkshop 렌더에서는 약 52%를 차지했으며, 이것이 junkshop이 1.31x밖에 스케일링되지 않은 이유입니다. 이 고정 비중이 클수록, 두 번째 카드가 더할 수 있는 몫은 줄어듭니다.
Q: GPU 두 장에서 V-Ray와 Octane이 Cycles, Redshift보다 스케일링이 좋은 이유는 무엇입니까? A: V-Ray Benchmark와 OctaneBench는 처리량 테스트로, 고정 설정 비용이 전체 실행 시간의 극히 일부에 불과합니다. 따라서 두 번째 카드가 거의 전부 유효한 작업에 투입되어 스케일링이 2.00x에 근접합니다. Cycles와 Redshift는 총 렌더 시간으로 측정되는데, 여기에는 두 번째 카드로 가속할 수 없는 비병렬 오버헤드가 포함되어 스케일링이 2x 미만에 머무릅니다.
Q: 렌더팜은 여러 머신에서 단일 프레임을 더 빠르게 렌더링할 수 있습니까? A: 하나의 프레임을 여러 머신에 분할하는 것은 멀티 노드 분산 렌더링으로, 고유의 조율 오버헤드가 있는 별개의 아키텍처이며 현재 단일 프레임에 대해서는 제공하지 않습니다. 대신 렌더팜의 속도는 프레임 병렬 렌더링에서 나옵니다. 여러 개의 전체 프레임이 서로 다른 머신에서 동시에 렌더링되므로 애니메이션은 더 빠르게 완성되지만, 단일 히어로 프레임은 대략 단일 머신 속도로 렌더링됩니다.
Q: 렌더링에 실제로 GPU가 몇 개나 필요합니까? A: 단일 머신 기준으로 GPU 두 장이 합리적인 상한선이며, 저희 벤치마크 노드도 그렇게 구성되어 있습니다. 그 이상에서는 실질적인 제약이 보통 카드 수가 아닌 VRAM입니다. 메모리에 맞지 않는 씬은 카드를 몇 장 추가해도 렌더링되지 않기 때문입니다. 애니메이션을 렌더링하는 경우, 실제 처리량 향상은 한 박스에 카드를 더 쌓는 것이 아니라 더 많은 머신에서 더 많은 프레임을 실행하는 데서 나옵니다.
Q: 이 벤치마크 수치는 공개된 Blender Open Data 점수와 비교할 수 있습니까? A: 아닙니다. 저희는 Blender Cycles를 Open Data 기본값보다 높은 200% 해상도로 실행하여, 각 렌더가 충분히 오래 지속되어 안정적인 스케일링 비율을 낼 수 있도록 했습니다. 따라서 저희의 원시 Cycles 시간은 공개 Open Data 리더보드와 의도적으로 비교할 수 없습니다. 씬은 표준 점수 매칭이 아닌 스케일링 측정을 위해 조정되었습니다.
Q: 매니지드 렌더팜을 사용하려면 GPU 드라이버와 라이선스를 직접 관리해야 합니까? A: 아닙니다. 풀 매니지드 렌더팜에서는 노드 구성, 드라이버, 렌더링 엔진 라이선스(V-Ray, Redshift, Octane)가 모두 관리되며 렌더링 요금에 포함되어 있으므로 직접 조립하거나 조정할 필요가 없습니다. Cycles는 무료 오픈소스이므로 별도의 라이선스가 필요하지 않습니다.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.