Multi-GPU-Skalierung: Was 1 vs. 2 GPUs beim Rendering wirklich bewirken (Benchmark 2026)
Überblick
Einleitung
TL;DR: Eine zweite GPU verdoppelt die Rendergeschwindigkeit selten, und wie stark sie hilft, hängt von der Render-Engine ab. Auf einer Dual-RTX-5090-Maschine skalierten Durchsatz-Benchmarks (V-Ray, Octane) nahe an 2,00x, während Renderzeit-Engines niedriger skalierten (Cycles 1,31x bis 1,59x, Redshift 1,68x), weil fixer Overhead pro Rendering einen Teil dessen auffrisst, was die zweite Karte beschleunigen kann. Zwei GPUs sind eine praktische Obergrenze für eine Maschine; darüber hinaus kommt Geschwindigkeit davon, mehr Frames auf mehr Maschinen laufen zu lassen, nicht davon, mehr Karten in eine Box zu stapeln.
Eine zweite GPU macht ein Rendering nicht doppelt so schnell. Das klingt selbstverständlich, sobald man es ausspricht, aber viele Hardware-Entscheidungen basieren auf der Annahme, dass zwei Karten doppelte Geschwindigkeit bedeuten. Im Juni 2026 haben wir eine unserer Dual-RTX-5090-Maschinen genommen und gemessen, was tatsächlich passiert, wenn man von einer auf zwei Karten wechselt, und zwar über vier Render-Engines und sieben Szenen- bzw. Benchmark-Kombinationen hinweg.
Die Kurzfassung: Es kommt auf die Engine an und auf die Szene. Durchsatz-orientierte Benchmarks (V-Ray, Octane) skalierten fast perfekt, etwa 2x. Renderzeit-Engines (Cycles, Redshift) skalierten niedriger, und je größer der Anteil eines Renderings, der fixer Overhead ist, desto weniger half die zweite Karte. Wir gehen die Zahlen durch, erklären, warum die Kurve so verläuft, wie sie verläuft, und sagen klar, wo diese Betrachtung endet. Zwei Karten sind die Obergrenze auf einer einzelnen Maschine. Darüber hinaus zu gehen ist eine andere Architektur, keine größere Version dieser.
Dies ist ein Hardware- und Benchmark-Beitrag mit GPU-Schwerpunkt. Es sei vorweg gesagt, dass GPU nur einen kleinen Teil der Aufträge auf unserer render farm ausmacht – der Großteil der Produktionsarbeit läuft nach wie vor als CPU-Rendering (V-Ray, Corona, Arnold auf CPU). Wenn jemand aber fragt, „Lohnt sich eine zweite GPU?", verdient er gemessene Zahlen und keinen Verkaufspitch. Also: hier sind die gemessenen Zahlen.
Testmethodik (und was diese Zahlen nicht sind)
Die Testmaschine lief unter Windows 11 Pro mit zwei RTX-5090-Karten auf NVIDIA-Treiber 596.36. Jedes Verhältnis in diesem Artikel vergleicht eine Karte mit zwei Karten auf derselben Maschine, mit demselben Treiber und denselben Softwareversionen, sodass sich zwischen den beiden Durchläufen sonst nichts ändert.
Jede Szene ist ein herstellerkonformer Benchmark: Blenders Open-Data-Szenen (bmw27, classroom, junkshop), Maxons „Vultures"-Szene für Redshift, der Chaos V-Ray Benchmark 6.00.02 und OctaneBench 2025.2.1. Keine Kundenprojekte, keine Produktionsdaten. Wir veröffentlichen hier keine Minutenangaben pro Frame, Dollar-pro-Frame-Werte oder Stromverbrauchszahlen, weil dieser Datensatz diese nicht enthält und wir sie nicht erfinden.
Ein Methodikhinweis, der die Lesart der Cycles-Zeilen beeinflusst: Wir haben Blender Cycles (4.5 LTS, OptiX) mit 200 % Auflösung betrieben, schwerer als der Open-Data-Standard, damit jedes Rendering lange genug dauert, um ein stabiles Skalierungsverhältnis zu liefern. Das bedeutet, dass unsere Cycles-Rohzeiten nicht mit öffentlichen Open-Data-Wertungen vergleichbar sind; sie sind auf die Messung der Skalierung ausgelegt, nicht auf Bestenlisten-Einträge. Cycles und Redshift werden in Renderzeit gemessen (Sekunden, niedriger ist besser; Median aus drei Durchläufen); V-Ray und Octane werden als Benchmark-Score gemessen (vpaths bzw. OctaneBench-Punkte, höher ist besser). Das sind zwei verschiedene Metrik-Typen, sodass absolute Zahlen niemals engine-übergreifend verglichen werden können. Nur das Skalierungsverhältnis innerhalb einer Engine ist ein fairer Vergleich.
Das Kernergebnis: 1x-bis-2x-Skalierung je Engine
Hier sind die wesentlichen Daten: was eine zweite identische RTX 5090 tatsächlich bringt, nach Engine und Szene.
| Engine | Szene | 1x RTX 5090 | 2x RTX 5090 | Skalierung |
|---|---|---|---|---|
| Cycles | bmw27 | 49,45 s | 32,06 s | 1,54x |
| Cycles | classroom | 23,09 s | 14,54 s | 1,59x |
| Cycles | junkshop | 19,71 s | 15,00 s | 1,31x |
| Redshift | Vultures | 57 s | 34 s | 1,68x |
| V-Ray GPU (CUDA) | Benchmark | 11.051 vpaths | 21.728 vpaths | 1,97x |
| V-Ray GPU (RTX) | Benchmark | 15.333 vpaths | 30.641 vpaths | 2,00x |
| Octane | OctaneBench-Suite | 1.690,78 | 3.380,72 | 2,00x |
Liest man dies von oben nach unten, ergibt sich eine klare Zweiteilung. V-Ray und Octane landen bei oder knapp unter 2,00x: Eine zweite GPU verdoppelt den Durchsatz nahezu. Cycles liegt zwischen 1,31x und 1,59x. Redshift liegt bei 1,68x.
Die Frage „Verdoppelt eine zweite GPU meine Geschwindigkeit?" hat also drei ehrliche Antworten, je nachdem, was Sie rendern: grundsätzlich ja für V-Ray und Octane, etwa 1,3x bis 1,6x für Cycles, und irgendwo dazwischen für Redshift. Wer behauptet, ein einziger Multiplikator gelte für das gesamte Rendering, hat es schlicht nicht gemessen.
Warum Durchsatz-Engines besser skalieren als Renderzeit-Engines
Das Muster ist nicht zufällig; es ergibt sich daraus, wie jeder Benchmark seine Zeit verbringt. V-Ray Benchmark und OctaneBench sind Durchsatz-Tests. Sie belasten die gesamte verfügbare Rechenleistung und geben einen Score aus, und der fixe Einrichtungsaufwand (Szene laden, Beschleunigungsstrukturen aufbauen, Gerät initialisieren) macht nur einen winzigen Bruchteil der Gesamtlaufzeit aus. Fügt man eine zweite Karte hinzu, fließt fast die gesamte zusätzliche Rechenleistung direkt in sinnvolle Arbeit, sodass man nahe an 2x herankommt. Das saubere 2,00x-Ergebnis von V-Ray RTX ist genau das, was man von einer Arbeitslast erwartet, bei der der Overhead praktisch vernachlässigbar ist.
Renderzeit-Engines verhalten sich anders. Wenn man ein Cycles- oder Redshift-Rendering in Wanduhr-Sekunden misst, misst man den gesamten Auftrag, und jeder Auftrag trägt einen fixen Block an Arbeit, der sich nicht auf Karten aufteilen lässt: Szene-Parsing, BVH-/Beschleunigungsstruktur-Aufbau, Kernel-Kompilierung und Warm-up, Gerätekoordination, das abschließende Pixel-Zusammenführen. Eine zweite GPU beschleunigt nur den Teil, der tatsächlich aufteilbar ist. Für den fixen Teil bewirkt sie nichts. Je größer der Anteil des fixen Overheads an der gesamten Renderzeit, desto weiter sinkt die Skalierung unter 2x.
Wie groß der fixe Overhead-Anteil je Rendering ist
Die beiden Zeitmessungen je Szene erlauben es uns, diesen fixen Teil direkt zu schätzen. Dauert ein Rendering T1 Sekunden auf einer Karte und T2 auf zwei, und wird nur der aufteilbare Teil schneller, beträgt der fixe Teil ungefähr 2 x T2 minus T1. Das ist eine einfache Zwei-Punkt-Schätzung, kein Profiler-Messwert, aber sie passt zu den Skalierungszahlen:
| Szene | 1 Karte | 2 Karten | Geschätzter fixer Anteil | Anteil am 1-Karten-Rendering |
|---|---|---|---|---|
| Cycles junkshop | 19,71 s | 15,00 s | etwa 10,3 s | etwa 52 % |
| Cycles bmw27 | 49,45 s | 32,06 s | etwa 14,7 s | etwa 30 % |
| Cycles classroom | 23,09 s | 14,54 s | etwa 6,0 s | etwa 26 % |
| Redshift Vultures | 57 s | 34 s | etwa 11 s | etwa 19 % |
Das ist der Grund, warum Cycles junkshop (1,31x) schlechter skaliert als Cycles classroom (1,59x): Etwa die Hälfte des junkshop-Renderings ist Arbeit, die eine zweite Karte nicht berühren kann, während classroom die meiste Zeit im aufteilbaren Teil verbringt. Gleiche Engine, gleiche Hardware; die Szene entscheidet, wie sehr die zweite Karte zählt.
Das verrät auch etwas Praktisches über schnellere Hardware. Eine schnellere Karte verkürzt den aufteilbaren Teil eines Renderings, aber der fixe Teil bleibt ungefähr gleich lang in Sekunden. Je schneller Ihr Ein-Karten-Rendering also bereits ist, desto größer wird der fixe Anteil, und desto weniger kann eine zweite Karte proportional beitragen. Die zweite Karte macht das Rendering trotzdem schneller; sie kann nur kein sauberes 2x liefern, wenn wenig langsame Arbeit zum Aufteilen übrig bleibt. Das ist gut zu wissen, bevor Sie Geld für das Stapeln identischer Karten ausgeben und lineare Renditen erwarten.
Zwei GPUs sind die Obergrenze pro Maschine – und warum das in Ordnung ist
Hier ziehen wir eine klare Linie, weil dies der Teil ist, den die meisten Multi-GPU-Inhalte stillschweigend übergehen. Die Maschine in diesem Benchmark verfügt über zwei GPUs, ebenso wie die anderen GPU-Maschinen auf unserer render farm. Zwei Karten sind die Obergrenze pro Maschine. Wir werden Ihnen keine 4x- oder 8x-Skalierungskurve für eine einzelne Maschine zeigen, weil das keine Konfiguration ist, die wir betreiben, und wir werden das auch nicht implizieren.
Mehr als zwei GPUs für einen einzelnen Frame zu nutzen, bedeutet verteiltes Multi-Node-Rendering: das Aufteilen eines Bildes auf mehrere Maschinen, mit dem gesamten Netzwerk-Koordinationsaufwand, Bucket-/Kachel-Management und Overhead, den das mit sich bringt. Das ist eine eigene Architektur, keine größere Version einer Zwei-Karten-Maschine. Wir bieten das heute für einen einzelnen Frame nicht an, also werden wir es auch nicht als „demnächst verfügbar"-Funktion mit Datum in Aussicht stellen.
Und für die meiste Produktionsarbeit ist die Zwei-GPU-Obergrenze nicht die entscheidende Einschränkung. Die Einschränkung, die zuerst zuschlägt, ist fast immer VRAM, nicht die Kartenanzahl: Eine Szene, die nicht in 32 GB passt, wird unabhängig davon, wie viele GPUs Sie darauf ansetzen, nicht rendern – das ist ein völlig anderes Problem (wir behandeln es in RTX 5090 VRAM-Grenzen für komplexe Szenen).
Wie Rendering über eine einzelne Maschine hinaus skaliert: Frames, nicht Karten
Dies ist die Unterscheidung, die es wert ist, verinnerlicht zu werden. Es gibt zwei völlig verschiedene Dinge, die Menschen mit „schneller rendern auf mehr Hardware" meinen:
- Einen Frame über viele GPUs oder Maschinen verteilen (Kachel-/Bucket-verteiltes Rendering). Das messen die 1x-bis-2x-Zahlen im Zwei-Karten-Maßstab. Bei Renderzeit-Engines trifft das schnell auf abnehmende Renditen, wie die Daten zeigen, wegen des fixen Overheads pro Rendering, und der Koordinationsaufwand wächst nur weiter, je mehr Maschinen man hinzufügt.
- Viele Frames über viele Maschinen verteilen (frame-paralleles Rendering). Jede Maschine rendert einen vollständigen Frame für sich, und die Frames einer Animation werden parallel verteilt. Es gibt keinen Einzelframe-Koordinationsaufwand zu bekämpfen, sodass dies sauber skaliert.
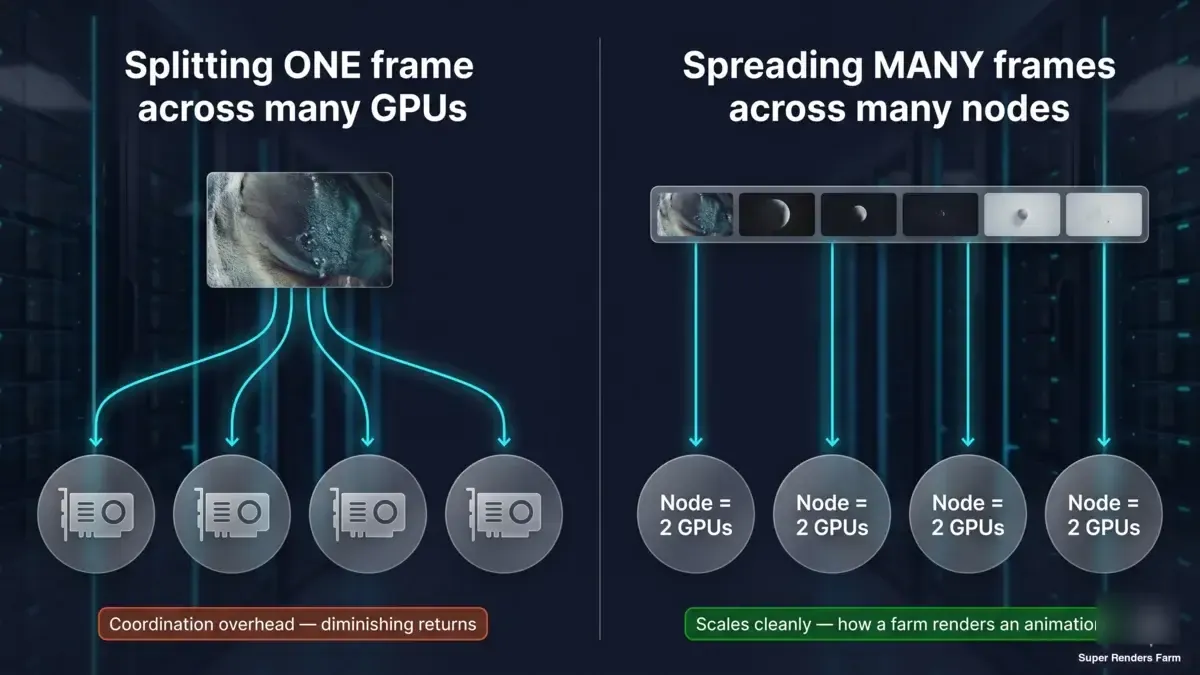 Zweipanel-Konzeptdiagramm: Ein Frame, aufgeteilt über mehrere GPUs, stößt auf Koordinationsaufwand und abnehmende Renditen; viele vollständige Frames, jeweils parallel auf einer eigenen Maschine gerendert, skalieren sauber
Auf unserer render farm werden CPU-Animationen auf die zweite Art gerendert: Ihre Frames werden gleichzeitig über viele CPU-Maschinen verteilt. GPU-Animationen werden auf die gleiche Weise verteilt, über welche RTX-5090-Karten auch immer gerade frei sind; unsere GPU-Flotte ist kleiner, daher verteilt sich ein GPU-Auftrag auf weniger Maschinen als ein CPU-Auftrag. Jeder Frame rendert weiterhin mit der hier gemessenen Geschwindigkeit pro Karte und dem gemessenen Szenen-Overhead. Die Abrechnung erfolgt pro Karten-Stunde, sodass das Verteilen eines Auftrags vor allem ändert, wie lange Sie warten; jede zusätzliche Karte lädt die Szene einmal, was die Gesamtkosten bei kurzen Aufträgen etwas erhöhen kann.
Die ehrliche Einordnung von Multi-GPU ist also enger gefasst als die Marketing-Version. Zwei Karten in einer Maschine geben Ihnen einen realen, messbaren Schub: nahe 2x bei V-Ray und Octane, bescheidener bei Cycles und Redshift. Darüber hinaus lautet die Antwort nicht „mehr Karten in die Box stapeln", sondern „mehr Frames auf mehr Maschinen laufen lassen".
Was das für Ihre Render-Entscheidung bedeutet
Wenn Sie zwischen einer und zwei Karten für eine Workstation entscheiden, sollte die Engine, mit der Sie arbeiten, die Entscheidung leiten. V-Ray- oder Octane-Nutzer erhalten fast eine vollständige Verdoppelung, und die zweite Karte ist leicht zu rechtfertigen. Cycles- und Redshift-Nutzer sollten bei Szenen wie diesen einen Zuwachs von etwa 1,3x bis 1,7x erwarten und abwägen, ob eine schnellere Einzelkarte die bessere Investition ist. Wenn Sie entscheiden, ob Sie lokal rendern oder die Arbeit an eine render farm übergeben, denken Sie daran: Der Vorteil der Farm liegt im parallelen Durchsatz über viele Frames, nicht in einem magischen Einzelframe-Multiplikator – ein einzelner Hero-Still-Frame wird auf einer Farm nicht dramatisch schneller rendern als auf einer vergleichbaren Workstation.
Für den Kontext zum Vergleich vollständig verwaltet vs. selbst betrieben (wer sich um Treiber, Lizenzen und Node-Konfiguration kümmert) behandelt unser Beitrag vollständig verwaltete vs. selbst betriebene render farm dies ausführlich. Auf unserer render farm ist die Render-Engine-Lizenzierung (V-Ray, Redshift, Octane) im Rendering-Tarif enthalten, und Node-Konfiguration sowie Treiber werden für Sie gepflegt, sodass Sie das nicht selbst zusammenstellen oder anpassen müssen. Für die Redshift-auf-Cinema-4D-Seite im Speziellen, wo der 1,68x-Skalierungswert liegt, siehe unseren Redshift render farm für Cinema 4D-Leitfaden.
Die hier vorgestellten Messungen sind bewusst frei von Übertreibungen. Eine zweite GPU ist ein realer Hebel mit realen Grenzen, Renderings profitieren umso weniger davon, je mehr ihrer Zeit fixer Overhead ist, und Geschwindigkeit jenseits einer Maschine ist eine Geschichte der Frame-Verteilung, keine des Karten-Stapelns. Zu wissen, welcher Hebel für Ihre Arbeitslast gilt, macht den Großteil der Entscheidung aus.
Wenn Sie einen Auftrag anhand dieser Multiplikatoren kalkulieren möchten, prüfen Sie unsere aktuellen Render-Farm-Preise oder lesen Sie unsere Methodik zum Cost-per-Frame-Benchmarking. Für den CPU-Vergleich der Hardware siehe unsere Cinebench-Werte für Cloud Rendering oder den V-Ray-Benchmark-Leitfaden. Für das Verhalten einer einzelnen RTX-5090-Karte siehe unseren Beitrag RTX 5090 GPU Cloud Rendering Performance.
FAQ
Q: Verdoppelt eine zweite GPU die Rendergeschwindigkeit? A: Normalerweise nicht. In unserem 2026er-Benchmark auf einer Dual-RTX-5090-Maschine skalierten Durchsatz-Engines wie V-Ray und Octane mit einer zweiten identischen Karte nahe an 2,00x, aber Renderzeit-Engines skalierten niedriger: Cycles lag zwischen 1,31x und 1,59x, Redshift erreichte 1,68x. Der Gewinn hängt von der Engine und der Szene ab, weil jedes Rendering fixen Overhead trägt, den eine zweite Karte nicht beschleunigen kann.
Q: Warum profitieren manche Renderings weniger von einer zweiten GPU als andere? A: Weil ein Teil jedes Renderings fixe Arbeit ist (Szene-Parsing, Beschleunigungsstruktur-Aufbau, Kernel-Warm-up), die auf einer oder zwei Karten ungefähr gleich lange dauert. Aus unseren Ein-Karten- und Zwei-Karten-Zeitmessungen betrug dieser fixe Teil etwa 19 % des Redshift-Vultures-Renderings und etwa 52 % des Cycles-junkshop-Renderings, weshalb junkshop nur mit 1,31x skalierte. Je größer dieser fixe Anteil, desto weniger kann die zweite Karte beitragen.
Q: Warum skalieren V-Ray und Octane über zwei GPUs besser als Cycles und Redshift? A: V-Ray Benchmark und OctaneBench sind Durchsatz-Tests, bei denen der fixe Einrichtungsaufwand nur einen winzigen Bruchteil der Laufzeit ausmacht, sodass eine zweite Karte fast vollständig in sinnvolle Arbeit fließt und die Skalierung sich 2,00x annähert. Cycles und Redshift werden als Gesamt-Renderzeit gemessen, die nicht-parallelen Overhead einschließt, den eine zweite Karte nicht beschleunigen kann, weshalb ihre Skalierung unter 2x bleibt.
Q: Kann eine render farm einen einzelnen Frame auf vielen Maschinen schneller rendern? A: Das Aufteilen eines Frames auf mehrere Maschinen ist verteiltes Multi-Node-Rendering, eine eigene Architektur mit eigenem Koordinationsaufwand, die wir heute für einen einzelnen Frame nicht anbieten. Die Geschwindigkeit der Farm kommt stattdessen aus frame-parallelem Rendering: viele vollständige Frames, gleichzeitig auf verschiedenen Maschinen gerendert, sodass eine Animation schneller fertig wird, während ein einzelner Hero-Frame mit etwa Einzelmaschinen-Geschwindigkeit rendert.
Q: Wie viele GPUs brauche ich wirklich zum Rendern? A: Für eine einzelne Maschine sind zwei GPUs eine sinnvolle Obergrenze, und das ist es, was unsere Benchmark-Maschine verwendet hat; darüber hinaus ist die praktische Einschränkung meist VRAM, nicht die Kartenanzahl, da eine Szene, die nicht in den Speicher passt, unabhängig von der Kartenanzahl nicht rendert. Wenn Sie Animationen rendern, kommt echter Durchsatz davon, mehr Frames auf mehr Maschinen laufen zu lassen, statt mehr Karten in eine Box zu stapeln.
Q: Sind diese Benchmark-Zahlen mit öffentlichen Blender-Open-Data-Wertungen vergleichbar? A: Nein. Wir haben Blender Cycles mit 200 % Auflösung betrieben, schwerer als der Open-Data-Standard, damit jedes Rendering lange genug dauert, um ein stabiles Skalierungsverhältnis zu erzeugen. Das macht unsere Cycles-Rohzeiten absichtlich unvergleichbar mit öffentlichen Open-Data-Bestenlisten; die Szenen wurden für die Skalierungsmessung angepasst, nicht um Standard-Scores zu erreichen.
Q: Muss ich GPU-Treiber und Lizenzen selbst verwalten, wenn ich eine vollständig verwaltete render farm nutze? A: Nein. Auf einer vollständig verwalteten Farm werden Node-Konfiguration, Treiber und Render-Engine-Lizenzen (V-Ray, Redshift, Octane) für Sie übernommen und sind im Rendering-Tarif enthalten, sodass das nichts ist, das Sie selbst zusammenstellen oder anpassen müssen. Cycles ist kostenlos und Open-Source, weshalb es keine separate Lizenz erfordert.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.