Escalabilidade Multi-GPU: O Que 1 vs 2 GPUs Realmente Faz na Renderização (Benchmark 2026)
Visão geral
Introdução
TL;DR: Uma segunda GPU raramente duplica a velocidade de renderização, e o quanto ajuda depende do motor de renderização. Numa máquina com RTX 5090 duplos, os benchmarks de débito (V-Ray, Octane) escalaram perto de 2,00x, enquanto os motores por tempo de renderização escalaram menos (Cycles de 1,31x a 1,59x, Redshift 1,68x), porque a latência fixa por render consome parte do que a segunda placa poderia acelerar. Dois GPUs são o limite prático para uma máquina; além disso, a velocidade vem de distribuir mais fotogramas por mais máquinas, e não de empilhar mais placas numa única caixa.
Uma segunda GPU não torna o render duas vezes mais rápido. Parece óbvio quando se diz em voz alta, mas muitas decisões de hardware são tomadas com base no pressuposto de que dois cartões significam o dobro da velocidade. Em junho de 2026, utilizámos uma das nossas máquinas com dois RTX 5090 e medimos o que acontece realmente quando se passa de uma placa para duas, em quatro motores de renderização e sete combinações de cena/benchmark.
A versão resumida: depende do motor e da cena. Os benchmarks de débito (V-Ray, Octane) escalaram quase na perfeição, perto de 2x. Os motores por tempo de renderização (Cycles, Redshift) escalaram menos, e quanto maior a parcela de um render que é latência fixa, menos a segunda placa ajudou. Vamos percorrer os números, explicar por que a curva se comporta desta forma e deixar claro onde isto termina. Dois cartões é o limite numa única máquina. Ir além disso é uma arquitetura diferente, não uma versão maior desta.
Este é um artigo de hardware/benchmark, portanto tem um peso considerável em GPU. Vale a pena dizer desde já que a GPU é a minoria do que corre na nossa render farm; a maior parte do trabalho de produção continua a ser renderização em CPU (V-Ray, Corona, Arnold em CPU). Mas quando alguém pergunta "uma segunda GPU vale a pena?", merece números medidos, não um discurso de vendas. Portanto, aqui estão os números medidos.
Como Testámos (e o Que Estes Números Não São)
A máquina de teste correu Windows 11 Pro com duas placas RTX 5090 no driver NVIDIA 596.36. Todos os rácios deste artigo comparam uma placa com duas placas na mesma máquina, com o mesmo driver e as mesmas versões de software, pelo que nada mais muda entre as duas execuções.
Cada cena é um benchmark padrão de fornecedor: as cenas Open Data do Blender (bmw27, classroom, junkshop), a cena "Vultures" da Maxon para Redshift, o Chaos V-Ray Benchmark 6.00.02, e o OctaneBench 2025.2.1. Sem projetos de clientes, sem ativos de produção. Não publicamos minutos por fotograma, dólares por fotograma nem valores de eletricidade, porque este conjunto de dados não os contém e não os inventamos.
Uma nota de método que afeta a leitura das linhas do Cycles: executámos o Blender Cycles (4.5 LTS, OptiX) a 200 % de resolução, mais pesado do que o padrão do Open Data, para que cada render dure tempo suficiente para produzir um rácio de escalabilidade estável. Isso significa que os nossos tempos brutos do Cycles não são comparáveis às pontuações públicas do Open Data; estão ajustados para medir escalabilidade, não para competir em classificações. Cycles e Redshift são medidos em tempo de renderização (segundos, quanto menor melhor; mediana de três execuções); V-Ray e Octane são medidos como pontuação de benchmark (vpaths ou pontos OctaneBench, quanto maior melhor). São dois tipos de métrica diferentes, pelo que os valores absolutos nunca se comparam entre motores. Apenas o rácio de escalabilidade dentro de cada motor é uma comparação justa.
O Resultado Principal: Escalabilidade de 1x para 2x por Motor
Aqui estão os dados centrais: o que uma segunda RTX 5090 idêntica proporciona realmente, por motor e cena.
| Motor | Cena | 1x RTX 5090 | 2x RTX 5090 | Escalabilidade |
|---|---|---|---|---|
| Cycles | bmw27 | 49,45 s | 32,06 s | 1,54x |
| Cycles | classroom | 23,09 s | 14,54 s | 1,59x |
| Cycles | junkshop | 19,71 s | 15,00 s | 1,31x |
| Redshift | Vultures | 57 s | 34 s | 1,68x |
| V-Ray GPU (CUDA) | benchmark | 11.051 vpaths | 21.728 vpaths | 1,97x |
| V-Ray GPU (RTX) | benchmark | 15.333 vpaths | 30.641 vpaths | 2,00x |
| Octane | OctaneBench suite | 1.690,78 | 3.380,72 | 2,00x |
Lendo de cima para baixo, surge uma divisão clara. V-Ray e Octane situam-se em ou ligeiramente abaixo de 2,00x: uma segunda GPU quase duplica o resultado. Cycles situa-se entre 1,31x e 1,59x. Redshift situa-se em 1,68x.
Portanto, "adicionar uma segunda GPU duplica a minha velocidade?" tem três respostas honestas diferentes consoante o que se renderiza: basicamente sim para V-Ray e Octane, um aumento de cerca de 1,3x a 1,6x para Cycles, e algures no meio para Redshift. Quem afirmar que um único multiplicador cobre toda a renderização não o mediu de facto.
Por Que os Motores de Débito Escalam Melhor Do Que os Motores por Tempo de Renderização
O padrão não é aleatório; decorre da forma como cada benchmark passa o seu tempo. O V-Ray Benchmark e o OctaneBench são testes de débito. Lançam uma carga de trabalho sobre toda a capacidade de computação disponível e reportam uma pontuação, sendo o custo fixo de configuração (carregar a cena, construir estruturas de aceleração, inicializar o dispositivo) uma fração diminuta do tempo total de execução. Adicionar uma segunda placa faz com que quase todo o silício extra vá diretamente para trabalho útil, ficando próximo de 2x. O resultado do V-Ray RTX a atingir um limpo 2,00x é exatamente o que se espera de uma carga de trabalho onde a latência é essencialmente ruído.
Os motores por tempo de renderização comportam-se de forma diferente. Quando se mede um render de Cycles ou Redshift em segundos de relógio de parede, está-se a cronometrar o trabalho completo, e cada trabalho carrega uma parcela fixa de trabalho que não se divide entre placas: análise da cena, construção da BVH/estrutura de aceleração, compilação de kernels e aquecimento, coordenação de dispositivos, resolução final de pixels. Uma segunda GPU acelera a parte que é efetivamente divisível. Não faz nada pela parte fixa. Quanto mais do tempo total de renderização for latência fixa, mais abaixo de 2x ficará a escalabilidade.
Que Parte de Cada Render É Latência Fixa
Os dois tempos por cena permitem estimar diretamente essa parte fixa. Se um render demora T1 segundos numa placa e T2 em duas, e apenas a parte divisível acelera, a parte fixa é aproximadamente 2 x T2 menos T1. Esta é uma estimativa simples de dois pontos, não uma leitura de profiler, mas está alinhada com os números de escalabilidade:
| Cena | 1 placa | 2 placas | Parte fixa estimada | Percentagem do render numa placa |
|---|---|---|---|---|
| Cycles junkshop | 19,71 s | 15,00 s | cerca de 10,3 s | cerca de 52 % |
| Cycles bmw27 | 49,45 s | 32,06 s | cerca de 14,7 s | cerca de 30 % |
| Cycles classroom | 23,09 s | 14,54 s | cerca de 6,0 s | cerca de 26 % |
| Redshift Vultures | 57 s | 34 s | cerca de 11 s | cerca de 19 % |
É por isso que o Cycles junkshop (1,31x) escala pior do que o Cycles classroom (1,59x): cerca de metade do render do junkshop é trabalho que uma segunda placa não consegue tocar, enquanto o classroom passa a maior parte do tempo na parte divisível. Mesmo motor, mesmo hardware; é a cena que decide o quanto a segunda placa importa.
Isto também revela algo prático sobre hardware mais rápido. Uma placa mais rápida encurta a parte divisível de um render, mas a parte fixa mantém-se aproximadamente com o mesmo número de segundos. Portanto, quanto mais rápido já for o render numa única placa, maior se torna a fatia fixa, e menos uma segunda placa consegue acrescentar em proporção. A segunda placa continua a tornar o render mais rápido; simplesmente não consegue entregar um 2x limpo quando resta pouco trabalho lento para dividir. Vale a pena saber isto antes de gastar dinheiro a empilhar placas idênticas à espera de retornos lineares.
Dois GPUs É o Limite por Máquina, e Por Que Isso Não É Problema
Aqui traçamos uma linha clara, porque é a parte que a maioria do conteúdo multi-GPU ignora silenciosamente. A máquina deste benchmark tem duas GPUs, tal como as outras máquinas GPU da nossa render farm. Dois cartões é o limite por máquina. Não vamos mostrar-lhe uma curva de escalabilidade de 4x ou 8x numa única máquina, porque essa não é uma configuração que executamos, e não vamos sugerir o contrário.
Ultrapassar dois GPUs num único fotograma significa renderização distribuída multi-nó: dividir uma imagem por várias máquinas, com toda a coordenação de rede, gestão de buckets/tiles e a latência que isso implica. Esta é uma arquitetura separada, não uma versão maior de uma caixa com dois cartões. Não é algo que oferecemos hoje para um único fotograma, pelo que não vamos apresentá-la como funcionalidade "brevemente" com uma data associada.
E, para a maior parte do trabalho de produção, o limite de dois GPUs não é a restrição que importa. A restrição que aparece primeiro é quase sempre a VRAM, não o número de cartões: uma cena que não cabe em 32 GB não renderiza independentemente de quantos GPUs se apontem a ela, o que é um problema completamente diferente (abordamos isso em limites de VRAM do RTX 5090 para cenas complexas).
Como a Renderização Escala Além de Uma Máquina: Fotogramas, Não Cartões
Esta é a distinção que vale a pena interiorizar. Há duas coisas completamente diferentes que as pessoas querem dizer com "renderizar mais rápido com mais hardware":
- Dividir um fotograma por muitas GPUs ou máquinas (renderização distribuída por tile/bucket). É isto que os números de 1x a 2x medem à escala de dois cartões. Atinge retornos decrescentes rapidamente nos motores por tempo de renderização, como os dados mostram, devido à latência fixa por render, e o custo de coordenação só cresce à medida que se adicionam máquinas.
- Distribuir muitos fotogramas por muitas máquinas (renderização paralela por fotograma). Cada máquina renderiza um fotograma completo de forma autónoma, e os fotogramas de uma animação são distribuídos em paralelo. Não existe latência de coordenação por fotograma a combater, pelo que esta abordagem escala de forma limpa.
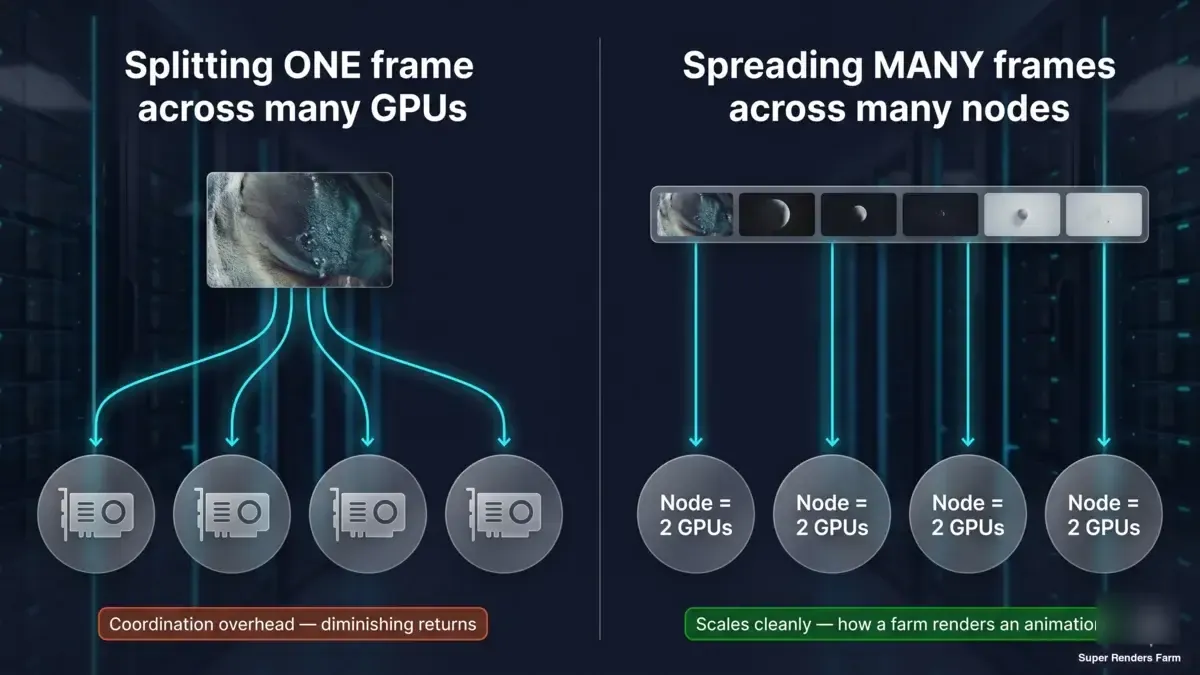 Diagrama conceptual em dois painéis: um fotograma dividido por vários GPUs gera latência de coordenação e retornos decrescentes; muitos fotogramas completos, cada um renderizado na sua própria máquina em paralelo, escalam de forma limpa
Na nossa render farm, as animações CPU são renderizadas da segunda forma: os seus fotogramas são distribuídos por muitas máquinas CPU em simultâneo. As animações GPU são distribuídas da mesma forma, por quaisquer placas RTX 5090 que estejam livres; a nossa frota GPU é mais pequena, pelo que um trabalho GPU se distribui por menos máquinas do que um trabalho CPU. Cada fotograma continua a renderizar à velocidade por placa e com a latência de cena medida aqui. A faturação é por hora-placa, pelo que distribuir um trabalho muda sobretudo quanto tempo se espera; cada placa adicional carrega a cena uma vez, o que pode acrescentar um pouco ao total em trabalhos curtos.
Portanto, a apresentação honesta do multi-GPU é mais restrita do que a versão de marketing. Duas placas numa máquina dão um aumento real e mensurável: próximo de 2x em V-Ray e Octane, mais modesto em Cycles e Redshift. Para além disso, a resposta não é "empilhar mais placas na caixa", é "distribuir mais fotogramas por mais máquinas".
O Que Isto Significa na Escolha de Como Renderizar
Se estiver a decidir entre uma placa e duas para uma estação de trabalho, o motor que utiliza deve orientar a decisão. Os utilizadores de V-Ray ou Octane obtêm quase uma duplicação total e a segunda placa é fácil de justificar. Os utilizadores de Cycles e Redshift devem esperar um aumento de cerca de 1,3x a 1,7x em cenas como estas, e devem ponderar se uma única placa mais rápida é o melhor investimento. Se estiver a decidir entre renderizar localmente ou entregar o trabalho a uma render farm, lembre-se de que a vantagem da render farm é o débito paralelo em muitos fotogramas, não um multiplicador mágico por fotograma único: um único fotograma estático importante não renderizará dramaticamente mais rápido numa render farm do que numa estação de trabalho equivalente.
Para contexto sobre a comparação entre gestão total e solução própria (quem trata dos drivers, licenças e configuração dos nós), o nosso guia sobre render farm totalmente gerida vs DIY cobre esse tema. Na nossa render farm, o licenciamento do motor de renderização (V-Ray, Redshift, Octane) está incluído na taxa de renderização e a configuração dos nós e os drivers são mantidos por nós, pelo que não são algo que se monta ou ajusta. Para o lado específico do Redshift no Cinema 4D, onde se enquadra o valor de escalabilidade de 1,68x, consulte o nosso guia sobre render farm Redshift para Cinema 4D.
As medições aqui apresentadas são deliberadamente sem exageros. Uma segunda GPU é uma alavanca real com limites reais, os renders ganham menos com ela quanto mais do seu tempo for latência fixa, e a velocidade além de uma máquina é uma história de distribuição de fotogramas, não de acumulação de placas. Saber qual alavanca se aplica à carga de trabalho é a maior parte da decisão.
Se estiver a orçamentar um trabalho a partir destes multiplicadores, consulte os atuais preços da render farm ou leia a metodologia de benchmarking de custo por fotograma. Para o lado CPU da comparação de hardware, consulte as nossas pontuações Cinebench para renderização na nuvem ou o guia V-Ray Benchmark. Para o comportamento do RTX 5090 com uma única placa, consulte o nosso artigo sobre desempenho de renderização na nuvem com RTX 5090.
FAQ
Q: Adicionar uma segunda GPU duplica a velocidade de renderização? A: Geralmente não. No nosso benchmark de 2026 numa máquina com RTX 5090 duplos, os motores de débito como V-Ray e Octane escalaram perto de 2,00x com uma segunda placa idêntica, mas os motores por tempo de renderização escalaram menos: Cycles ficou entre 1,31x e 1,59x e Redshift atingiu 1,68x. O ganho depende do motor e da cena, porque cada render carrega latência fixa que uma segunda placa não consegue acelerar.
Q: Por que alguns renders ganham menos com uma segunda GPU do que outros? A: Porque parte de cada render é trabalho fixo (análise de cena, construção da estrutura de aceleração, aquecimento de kernels) que demora aproximadamente o mesmo tempo numa placa ou em duas. A partir dos nossos tempos com uma e duas placas, essa parte fixa representava cerca de 19 % do render Redshift Vultures e cerca de 52 % do render Cycles junkshop, motivo pelo qual o junkshop escalou apenas 1,31x. Quanto maior essa fatia fixa, menos a segunda placa consegue acrescentar.
Q: Por que V-Ray e Octane escalam melhor do que Cycles e Redshift em duas GPUs? A: O V-Ray Benchmark e o OctaneBench são testes de débito onde o custo fixo de configuração é uma fração diminuta da execução, pelo que uma segunda placa vai quase inteiramente para trabalho útil e a escalabilidade aproxima-se de 2,00x. Cycles e Redshift são medidos como tempo total de renderização, que inclui latência não paralela que uma segunda placa não consegue acelerar, pelo que a sua escalabilidade fica abaixo de 2x.
Q: Uma render farm consegue tornar um único fotograma mais rápido em muitas máquinas? A: Dividir um único fotograma por várias máquinas é renderização distribuída multi-nó, uma arquitetura separada com a sua própria latência de coordenação, que não oferecemos hoje para um único fotograma. Em vez disso, a velocidade de uma render farm vem da renderização paralela por fotograma, muitos fotogramas completos renderizados ao mesmo tempo em máquinas diferentes, pelo que uma animação termina mais depressa enquanto um único fotograma importante renderiza aproximadamente à velocidade de uma única máquina.
Q: De quantos GPUs preciso realmente para renderizar? A: Para uma única máquina, dois GPUs é um limite sensato e é o que a nossa máquina de benchmark utilizou; além disso, a restrição prática costuma ser a VRAM, não o número de cartões, uma vez que uma cena que não cabe em memória não renderiza independentemente de quantas placas se adicionem. Se renderizar animações, o verdadeiro débito vem de distribuir mais fotogramas por mais máquinas, e não de empilhar mais placas numa única máquina.
Q: Estes números de benchmark são comparáveis às pontuações públicas do Blender Open Data? A: Não. Executámos o Blender Cycles a 200 % de resolução, mais pesado do que o padrão do Open Data, para que cada render dure tempo suficiente para produzir um rácio de escalabilidade estável. Isso torna os nossos tempos brutos de Cycles intencionalmente incomparáveis com as classificações públicas do Open Data; as cenas foram ajustadas para medir escalabilidade, não para corresponder a pontuações padrão.
Q: Preciso de gerir drivers de GPU e licenças para usar uma render farm gerida? A: Não. Numa render farm totalmente gerida, a configuração dos nós, os drivers e o licenciamento do motor de renderização (V-Ray, Redshift, Octane) são tratados por nós e incluídos na taxa de renderização, pelo que não são algo que se monta ou ajusta. Cycles é gratuito e de código aberto, pelo que não tem licença separada.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.