Scaling multi-GPU: cosa fa davvero una seconda GPU per il rendering (benchmark 2026)
Panoramica
Introduzione
TL;DR: Una seconda GPU raramente raddoppia la velocità di rendering, e quanto aiuta dipende dal motore di rendering. Su una macchina dual RTX 5090, i benchmark throughput (V-Ray, Octane) hanno scalato vicino a 2,00x, mentre i motori render-time hanno scalato meno (Cycles da 1,31x a 1,59x, Redshift 1,68x), perché l'overhead fisso per render limita quanto la seconda scheda può velocizzare. Due GPU sono un limite pratico per una singola macchina; oltre quel punto, la velocità arriva eseguendo più frame su più macchine, non accumulando più schede in un unico box.
Una seconda GPU non rende un render il doppio più veloce. Detto ad alta voce sembra ovvio, ma molte decisioni hardware si basano sul presupposto che due schede significhino velocità doppia. A giugno 2026 abbiamo preso una delle nostre macchine dual RTX 5090 e misurato cosa succede davvero quando passi da una scheda a due, su quattro motori di rendering e sette combinazioni scena/benchmark.
La versione breve: dipende dal motore, e dalla scena. I benchmark di tipo throughput (V-Ray, Octane) hanno scalato quasi perfettamente, intorno a 2x. I motori render-time (Cycles, Redshift) hanno scalato meno, e più grande era la quota di un render occupata da overhead fisso, meno aiutava la seconda scheda. Di seguito esaminiamo i numeri, spieghiamo perché la curva si piega in questo modo e chiariamo dove questo si ferma. Due schede è il limite su una singola macchina. Andare oltre significa un'architettura diversa, non una versione più grande di questa.
Questo è un articolo hardware/benchmark, quindi è orientato alle GPU. Vale la pena dirlo subito: la GPU è la minoranza di ciò che gira sulla nostra render farm; la maggior parte del lavoro di produzione qui è ancora CPU rendering (V-Ray, Corona, Arnold su CPU). Ma quando qualcuno chiede "vale la pena una seconda GPU?", merita numeri misurati, non un discorso commerciale. Ecco quindi i numeri misurati.
Come abbiamo testato (e cosa questi numeri non sono)
La macchina di test eseguiva Windows 11 Pro con due schede RTX 5090 e driver NVIDIA 596.36. Ogni rapporto in questo articolo confronta una scheda contro due schede sulla stessa macchina, con lo stesso driver e le stesse versioni software, quindi nulla cambia tra le due esecuzioni a parte il numero di schede.
Ogni scena è un benchmark standard del produttore: le scene Open Data di Blender (bmw27, classroom, junkshop), la scena "Vultures" di Maxon per Redshift, il Chaos V-Ray Benchmark 6.00.02 e OctaneBench 2025.2.1. Nessun progetto cliente, nessun asset di produzione. Non pubblichiamo qui i minuti per frame, il costo per frame o i dati sui consumi elettrici, perché questo dataset non li contiene e non li inventiamo.
Una nota metodologica che riguarda come leggere le righe di Cycles: abbiamo eseguito Blender Cycles (4.5 LTS, OptiX) al 200% di risoluzione, più pesante del default Open Data, in modo che ogni render duri abbastanza a lungo da produrre un rapporto di scaling stabile. Questo significa che i nostri tempi grezzi di Cycles non sono comparabili ai punteggi pubblici Open Data; sono calibrati per misurare lo scaling, non per le classifiche. Cycles e Redshift sono misurati in tempo di rendering (secondi, minore è meglio; mediana di tre esecuzioni); V-Ray e Octane sono misurati come punteggio benchmark (vpaths o punti OctaneBench, maggiore è meglio). Sono due tipi di metrica diversi, quindi i numeri assoluti non si confrontano mai tra motori. Solo il rapporto di scaling all'interno di un motore è un confronto omogeneo.
Il risultato principale: scaling da 1x a 2x per motore
Ecco i dati principali: cosa ti offre davvero una seconda RTX 5090 identica, per motore e scena.
| Motore | Scena | 1x RTX 5090 | 2x RTX 5090 | Scaling |
|---|---|---|---|---|
| Cycles | bmw27 | 49,45 s | 32,06 s | 1,54x |
| Cycles | classroom | 23,09 s | 14,54 s | 1,59x |
| Cycles | junkshop | 19,71 s | 15,00 s | 1,31x |
| Redshift | Vultures | 57 s | 34 s | 1,68x |
| V-Ray GPU (CUDA) | benchmark | 11.051 vpaths | 21.728 vpaths | 1,97x |
| V-Ray GPU (RTX) | benchmark | 15.333 vpaths | 30.641 vpaths | 2,00x |
| Octane | suite OctaneBench | 1.690,78 | 3.380,72 | 2,00x |
Leggendo dall'alto verso il basso emerge una netta divisione. V-Ray e Octane si attestano a 2,00x o appena sotto: una seconda GPU raddoppia quasi perfettamente l'output. Cycles si colloca tra 1,31x e 1,59x. Redshift si ferma a 1,68x.
Quindi alla domanda "aggiungere una seconda GPU raddoppia la mia velocità?" ci sono tre risposte oneste diverse a seconda di cosa renderizzi: sostanzialmente sì per V-Ray e Octane, circa un incremento di 1,3x-1,6x per Cycles, e qualcosa nel mezzo per Redshift. Chiunque ti dica che un singolo moltiplicatore copre tutto il rendering non ha davvero misurato nulla.
Perché i motori throughput scalano meglio dei motori render-time
Lo schema non è casuale; deriva da come ogni benchmark impiega il proprio tempo. V-Ray Benchmark e OctaneBench sono test di throughput. Distribuiscono un carico di lavoro su qualsiasi unità di calcolo disponibile e riportano un punteggio, e il costo fisso di avvio (caricamento della scena, costruzione delle strutture di accelerazione, inizializzazione del dispositivo) è una frazione minima del totale. Aggiungi una seconda scheda e quasi tutto quel silicio in più va direttamente in lavoro utile, quindi ottieni un valore vicino a 2x. Il risultato V-Ray RTX che raggiunge un netto 2,00x è esattamente ciò che ci si aspetterebbe da un carico di lavoro in cui l'overhead è essenzialmente trascurabile.
I motori render-time si comportano diversamente. Quando misuri un render Cycles o Redshift in secondi a orologio, stai cronometrando l'intero lavoro, e ogni lavoro porta con sé una quota fissa di lavoro che non si divide tra le schede: parsing della scena, costruzione della struttura BVH/accelerazione, compilazione e avvio del kernel, coordinamento del dispositivo, il resolve finale dei pixel. Una seconda GPU accelera la parte effettivamente divisibile. Non fa nulla per la parte fissa. Più il tuo tempo di rendering totale è occupato dall'overhead fisso, più il tuo scaling scende sotto 2x.
Quanto overhead fisso c'è in ogni render
I due tempi per scena ci permettono di stimare direttamente quella parte fissa. Se un render impiega T1 secondi su una scheda e T2 su due, e solo la parte divisibile diventa più veloce, la parte fissa è circa 2 x T2 meno T1. È una stima semplice a due punti, non una lettura da profiler, ma è coerente con i numeri di scaling:
| Scena | 1 scheda | 2 schede | Parte fissa stimata | Quota del render a 1 scheda |
|---|---|---|---|---|
| Cycles junkshop | 19,71 s | 15,00 s | circa 10,3 s | circa 52% |
| Cycles bmw27 | 49,45 s | 32,06 s | circa 14,7 s | circa 30% |
| Cycles classroom | 23,09 s | 14,54 s | circa 6,0 s | circa 26% |
| Redshift Vultures | 57 s | 34 s | circa 11 s | circa 19% |
Ecco perché Cycles junkshop (1,31x) scala peggio di Cycles classroom (1,59x): circa metà del render di junkshop è lavoro che una seconda scheda non può toccare, mentre classroom trascorre la maggior parte del tempo nella parte divisibile. Stesso motore, stesso hardware; è la scena a decidere quanto conta la seconda scheda.
Ci dice anche qualcosa di pratico sull'hardware più veloce. Una scheda più veloce accorcia la parte divisibile di un render, ma la parte fissa resta più o meno lo stesso numero di secondi. Quindi più veloce è già il tuo render a singola scheda, più grande diventa la quota fissa, e meno una seconda scheda può aggiungere in proporzione. La seconda scheda rende comunque il render più veloce; semplicemente non può offrire un netto 2x quando resta poco lavoro lento da dividere. Vale la pena saperlo prima di spendere soldi accumulando schede identiche aspettandosi rendimenti lineari.
Due GPU sono il limite per macchina, e perché va bene così
Qui tracciamo una linea netta, perché è la parte che la maggior parte dei contenuti sul multi-GPU tende a saltare in silenzio. La macchina di questo benchmark ha due GPU, e così le altre macchine GPU della nostra farm. Due schede sono il limite per macchina. Non ti mostreremo una curva di scaling 4x o 8x su singola macchina, perché non è una configurazione che utilizziamo, e non lasceremo intendere il contrario.
Superare le due GPU su un singolo frame significa rendering distribuito multi-nodo: dividere un'immagine tra più macchine, con tutto il coordinamento di rete, la gestione dei bucket/tile e l'overhead che ne derivano. Si tratta di un'architettura separata, non di una versione più grande di una macchina a due schede. Non è qualcosa che offriamo oggi per un singolo frame, quindi non lo presenteremo come una funzionalità "in arrivo" con una data allegata.
E per la maggior parte del lavoro di produzione, il limite delle due GPU non è il vincolo che conta davvero. Il vincolo che si fa sentire per primo è quasi sempre la VRAM, non il numero di schede: una scena che non entra in 32 GB non renderizza indipendentemente da quante GPU punti su di essa, il che è un problema completamente diverso (lo trattiamo in Limiti VRAM di RTX 5090 per scene complesse).
Come scala il rendering oltre una singola macchina: frame, non schede
Questa è la distinzione che vale la pena interiorizzare. Ci sono due cose completamente diverse che le persone intendono con "renderizzare più velocemente su più hardware":
- Dividere un frame tra molte GPU o macchine (rendering distribuito tile/bucket). È ciò che i numeri da 1x a 2x misurano alla scala a due schede. Incontra rapidamente rendimenti decrescenti sui motori render-time, come mostrano i dati, a causa dell'overhead fisso per render, e il costo di coordinamento cresce solo man mano che aggiungi macchine.
- Distribuire molti frame su molte macchine (rendering frame-parallelo). Ogni macchina renderizza un frame intero per conto proprio, e i frame di un'animazione vengono distribuiti in parallelo. Non c'è overhead di coordinamento su singolo frame da combattere, quindi scala in modo pulito.
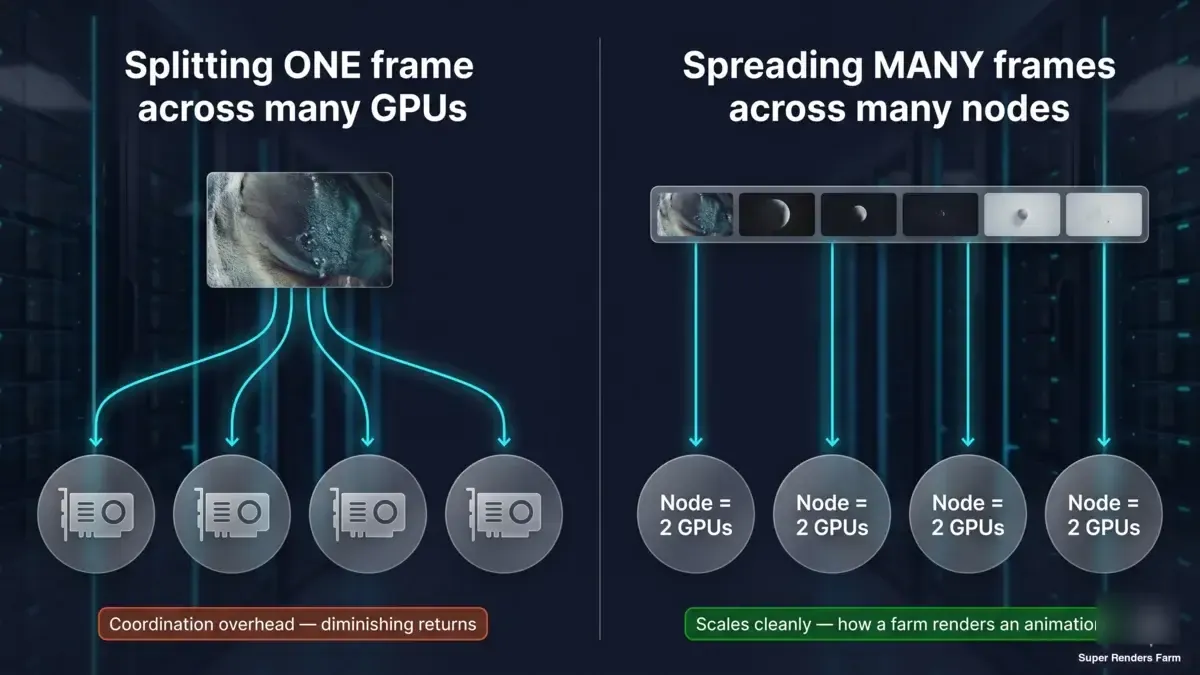 Diagramma concettuale a due pannelli: un frame diviso tra più GPU incontra overhead di coordinamento e rendimenti decrescenti; molti frame interi, ciascuno renderizzato sulla propria macchina in parallelo, scalano in modo pulito
Sulla nostra farm, le animazioni CPU vengono renderizzate nel secondo modo: i loro frame vengono distribuiti su molte macchine CPU contemporaneamente. Le animazioni GPU vengono distribuite allo stesso modo, sulle schede RTX 5090 libere; la nostra flotta GPU è più piccola, quindi un lavoro GPU si distribuisce su meno macchine rispetto a un lavoro CPU. Ogni frame renderizza comunque alla velocità per scheda e con l'overhead di scena misurati qui. La fatturazione è per ora-scheda, quindi distribuire un lavoro cambia soprattutto quanto aspetti; ogni scheda aggiuntiva carica la scena una volta, il che può aggiungere un po' al totale sui lavori brevi.
Quindi il quadro onesto del multi-GPU è più ristretto della versione da marketing. Due schede in una macchina ti danno un boost reale e misurabile: vicino a 2x su V-Ray e Octane, più modesto su Cycles e Redshift. Oltre questo, la risposta non è "aggiungi più schede nel box", ma "esegui più frame su più macchine".
Cosa significa questo quando scegli come renderizzare
Se stai decidendo tra una scheda e due per una workstation, il motore che usi dovrebbe guidare la scelta. Chi usa V-Ray o Octane ottiene quasi un raddoppio completo e la seconda scheda è facile da giustificare. Chi usa Cycles e Redshift dovrebbe aspettarsi un incremento di circa 1,3x-1,7x su scene come queste, e dovrebbe valutare se una singola scheda più veloce sia la spesa migliore. Se stai decidendo se renderizzare in locale o affidare il lavoro a una farm, ricorda che il vantaggio della farm è il throughput parallelo su molti frame, non un moltiplicatore magico su singolo frame: un singolo frame hero non renderizzerà drammaticamente più veloce su una farm rispetto a una workstation comparabile.
Per un approfondimento sul compromesso tra gestione affidata e fai-da-te (chi si occupa di driver, licenze e configurazione dei nodi), il nostro confronto render farm completamente gestita vs fai-da-te lo copre. Sulla nostra farm, le licenze dei motori di rendering (V-Ray, Redshift, Octane) sono incluse nella tariffa di rendering e la configurazione dei nodi e i driver vengono mantenuti per te, quindi non sono qualcosa che assembli o regoli da solo. Per il lato Redshift su Cinema 4D nello specifico, dove si colloca il valore di scaling 1,68x, consulta la nostra guida render farm Redshift per Cinema 4D.
Le misurazioni qui presentate sono deliberatamente prive di enfasi. Una seconda GPU è una leva reale con limiti reali, i render ne guadagnano meno quanto più il loro tempo è overhead fisso, e la velocità oltre una singola macchina è una storia di distribuzione dei frame, non di accumulo di schede. Sapere quale leva si applica al tuo carico di lavoro è la maggior parte della decisione.
Se stai definendo il prezzo di un lavoro a partire da questi moltiplicatori, controlla i prezzi attuali della render farm o leggi la metodologia di benchmarking del costo per frame. Per il lato CPU del confronto hardware, consulta i nostri punteggi Cinebench per il rendering cloud o la guida al V-Ray Benchmark. Per il comportamento su singola scheda della RTX 5090, consulta il nostro approfondimento prestazioni di rendering cloud con RTX 5090.
FAQ
Q: Aggiungere una seconda GPU raddoppia la velocità di rendering? A: Di solito no. Nel nostro benchmark 2026 su una macchina dual RTX 5090, i motori throughput come V-Ray e Octane hanno scalato vicino a 2,00x con una seconda scheda identica, ma i motori render-time hanno scalato meno: Cycles si è attestato tra 1,31x e 1,59x e Redshift ha raggiunto 1,68x. Il guadagno dipende dal motore e dalla scena, perché ogni render porta con sé un overhead fisso che una seconda scheda non può accelerare.
Q: Perché alcuni render guadagnano meno da una seconda GPU rispetto ad altri? A: Perché una parte di ogni render è lavoro fisso (parsing della scena, costruzione della struttura di accelerazione, avvio del kernel) che richiede circa lo stesso tempo su una scheda o su due. Dai nostri tempi a una e due schede, quella parte fissa era circa il 19% del render Redshift Vultures e circa il 52% del render Cycles junkshop, motivo per cui junkshop ha scalato solo 1,31x. Maggiore è quella quota fissa, minore è quanto può aggiungere la seconda scheda.
Q: Perché V-Ray e Octane scalano meglio di Cycles e Redshift su due GPU? A: V-Ray Benchmark e OctaneBench sono test di throughput in cui il costo fisso di avvio è una frazione minima dell'esecuzione, quindi una seconda scheda va quasi interamente in lavoro utile e lo scaling si avvicina a 2,00x. Cycles e Redshift sono misurati come tempo di rendering totale, che include overhead non parallelizzabile che una seconda scheda non può accelerare, quindi il loro scaling resta sotto 2x.
Q: Una render farm può far renderizzare più velocemente un singolo frame su più macchine? A: Dividere un frame tra più macchine è rendering distribuito multi-nodo, che è un'architettura separata con il proprio overhead di coordinamento e non è qualcosa che offriamo oggi per un singolo frame. La velocità della farm deriva invece dal rendering frame-parallelo, molti frame interi renderizzati contemporaneamente su macchine diverse, così un'animazione finisce più velocemente mentre un singolo frame hero renderizza a una velocità simile a quella di una singola macchina.
Q: Di quante GPU ho davvero bisogno per il rendering? A: Per una singola macchina, due GPU sono un limite sensato ed è quello che ha usato la nostra macchina di benchmark; oltre questo, il vincolo pratico è di solito la VRAM, non il numero di schede, poiché una scena che non entra in memoria non renderizza indipendentemente da quante schede aggiungi. Se renderizzi animazioni, il throughput reale deriva dall'eseguire più frame su più macchine piuttosto che accumulare più schede in un unico box.
Q: Questi numeri di benchmark sono comparabili ai punteggi pubblici di Blender Open Data? A: No. Abbiamo eseguito Blender Cycles al 200% di risoluzione, più pesante del default Open Data, in modo che ogni render duri abbastanza a lungo da produrre un rapporto di scaling stabile. Questo rende i nostri tempi grezzi di Cycles intenzionalmente non comparabili alle classifiche pubbliche Open Data; le scene erano calibrate per misurare lo scaling, non per corrispondere ai punteggi standard.
Q: Devo gestire driver GPU e licenze per usare una render farm gestita? A: No. Su una farm completamente gestita, la configurazione dei nodi, i driver e le licenze dei motori di rendering (V-Ray, Redshift, Octane) vengono gestiti per te e inclusi nella tariffa di rendering, quindi non sono qualcosa che assembli o regoli. Cycles è gratuito e open-source, quindi non richiede una licenza separata.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.