Escalado Multi-GPU: Lo que 1 vs 2 GPUs Hace Realmente en el Renderizado (Benchmark 2026)
Resumen
Introducción
TL;DR: Una segunda GPU rara vez duplica la velocidad de renderizado, y cuánto ayuda depende del motor de renderizado. En una máquina con dos RTX 5090, los benchmarks de rendimiento (V-Ray, Octane) escalaron cerca de 2,00x, mientras que los motores de tiempo de renderizado escalaron menos (Cycles de 1,31x a 1,59x, Redshift 1,68x), porque la sobrecarga fija de cada renderizado reduce lo que la segunda tarjeta puede acelerar. Dos GPUs es un límite práctico para una máquina; más allá de eso, la velocidad proviene de ejecutar más fotogramas en más máquinas, no de apilar más tarjetas en una sola caja.
Una segunda GPU no hace que el renderizado sea el doble de rápido. Eso suena obvio una vez que se dice en voz alta, pero muchas decisiones de hardware se toman bajo el supuesto de que dos tarjetas significan el doble de velocidad. En junio de 2026 tomamos una de nuestras máquinas con dos RTX 5090 y medimos lo que realmente ocurre al pasar de una tarjeta a dos, en cuatro motores de renderizado y siete combinaciones de escenas y benchmarks.
La versión corta: depende del motor, y de la escena. Los benchmarks de tipo rendimiento (V-Ray, Octane) escalaron casi a la perfección, en torno a 2x. Los motores de tiempo de renderizado (Cycles, Redshift) escalaron menos, y cuanto mayor era la parte del renderizado que es sobrecarga fija, menos ayudaba la segunda tarjeta. Repasaremos los números, explicaremos por qué la curva se dobla de esa manera y dejaremos claro dónde termina esto. Dos tarjetas es el límite en una sola máquina. Ir más allá es una arquitectura distinta, no una versión ampliada de esta.
Este es un artículo de hardware y benchmarks, por lo que está orientado a las GPU. Vale la pena decir desde el principio que las GPU son la minoría de lo que circula por nuestra render farm: la mayor parte del trabajo de producción aquí sigue siendo renderizado por CPU (V-Ray, Corona, Arnold en CPU). Pero cuando alguien pregunta si vale la pena una segunda GPU, merece números medidos, no un argumento de venta. Aquí están los números medidos.
Cómo Realizamos las Pruebas (y lo que Estos Números No Son)
La máquina de prueba ejecutó Windows 11 Pro con dos tarjetas RTX 5090 con el driver 596.36 de NVIDIA. Cada ratio de este artículo compara una tarjeta frente a dos tarjetas en esa misma máquina, con el mismo driver y las mismas versiones de software, de modo que nada más cambia entre ambas ejecuciones.
Cada escena es un benchmark estándar del fabricante: las escenas Open Data de Blender (bmw27, classroom, junkshop), la escena "Vultures" de Maxon para Redshift, el Chaos V-Ray Benchmark 6.00.02 y OctaneBench 2025.2.1. Ningún proyecto de cliente, ningún asset de producción. Aquí no publicamos minutos por fotograma, dólares por fotograma ni cifras de consumo eléctrico, porque este conjunto de datos no los contiene y no los inventamos.
Una nota metodológica que afecta a la lectura de las filas de Cycles: ejecutamos Blender Cycles (4.5 LTS, OptiX) al 200% de resolución, más pesado que el estándar de Open Data, para que cada renderizado dure lo suficiente y produzca un ratio de escalado estable. Eso significa que nuestros tiempos brutos de Cycles no son comparables con las puntuaciones públicas de Open Data: están ajustados para medir el escalado, no para competir en clasificaciones. Cycles y Redshift se miden en tiempo de renderizado (segundos, cuanto menor mejor; mediana de tres ejecuciones); V-Ray y Octane se miden como puntuación de benchmark (vpaths o puntos de OctaneBench, cuanto mayor mejor). Estos son dos tipos de métricas distintos, por lo que los números absolutos nunca se comparan entre motores. Solo el ratio de escalado dentro de un mismo motor es una comparación justa.
El Resultado Central: Escalado de 1x a 2x por Motor
Aquí están los datos principales: lo que realmente aporta una segunda RTX 5090 idéntica, por motor y escena.
| Motor | Escena | 1x RTX 5090 | 2x RTX 5090 | Escalado |
|---|---|---|---|---|
| Cycles | bmw27 | 49,45 s | 32,06 s | 1,54x |
| Cycles | classroom | 23,09 s | 14,54 s | 1,59x |
| Cycles | junkshop | 19,71 s | 15,00 s | 1,31x |
| Redshift | Vultures | 57 s | 34 s | 1,68x |
| V-Ray GPU (CUDA) | benchmark | 11.051 vpaths | 21.728 vpaths | 1,97x |
| V-Ray GPU (RTX) | benchmark | 15.333 vpaths | 30.641 vpaths | 2,00x |
| Octane | OctaneBench suite | 1.690,78 | 3.380,72 | 2,00x |
Leyendo de arriba a abajo, aparece una división clara. V-Ray y Octane se sitúan en 2,00x o justo por debajo: una segunda GPU casi duplica el rendimiento. Cycles queda entre 1,31x y 1,59x. Redshift se sitúa en 1,68x.
Así que "¿añadir una segunda GPU duplica mi velocidad?" tiene tres respuestas honestas distintas según lo que renderice: básicamente sí para V-Ray y Octane, un aumento de aproximadamente 1,3x a 1,6x para Cycles, y un punto intermedio para Redshift. Quien le diga que un único multiplicador cubre todo el renderizado es que no lo ha medido realmente.
Por qué los Motores de Rendimiento Escalan Mejor que los Motores de Tiempo de Renderizado
El patrón no es aleatorio: proviene de cómo cada benchmark emplea su tiempo. V-Ray Benchmark y OctaneBench son pruebas de rendimiento. Lanzan una carga de trabajo sobre la capacidad de cómputo disponible y reportan una puntuación, y el coste fijo de configuración (cargar la escena, construir estructuras de aceleración, inicializar el dispositivo) es una fracción mínima del tiempo total. Añada una segunda tarjeta y casi todo ese silicio extra va directo al trabajo útil, por lo que se obtiene cerca de 2x. El resultado de V-Ray RTX alcanzando un 2,00x limpio es exactamente lo que cabría esperar de una carga de trabajo donde la sobrecarga es prácticamente ruido.
Los motores de tiempo de renderizado se comportan de forma diferente. Cuando se mide un renderizado de Cycles o Redshift en segundos de reloj de pared, se cronometra el trabajo completo, y cada trabajo lleva consigo una porción fija de trabajo que no se divide entre tarjetas: análisis de la escena, construcción de la estructura BVH o de aceleración, compilación y calentamiento del kernel, coordinación del dispositivo, la resolución final de los píxeles. Una segunda GPU acelera la parte que realmente se puede dividir. No hace nada por la parte fija. Cuanto mayor sea la fracción del tiempo total de renderizado que corresponde a la sobrecarga fija, más por debajo de 2x quedará el escalado.
Qué Parte de Cada Renderizado Es Sobrecarga Fija
Los dos tiempos por escena nos permiten estimar esa parte fija directamente. Si un renderizado tarda T1 segundos en una tarjeta y T2 en dos, y solo la parte divisible se acelera, la parte fija es aproximadamente 2 x T2 menos T1. Esta es una estimación simple de dos puntos, no una lectura de perfilador, pero coincide con los números de escalado:
| Escena | 1 tarjeta | 2 tarjetas | Parte fija estimada | Proporción del renderizado a 1 tarjeta |
|---|---|---|---|---|
| Cycles junkshop | 19,71 s | 15,00 s | unos 10,3 s | alrededor del 52% |
| Cycles bmw27 | 49,45 s | 32,06 s | unos 14,7 s | alrededor del 30% |
| Cycles classroom | 23,09 s | 14,54 s | unos 6,0 s | alrededor del 26% |
| Redshift Vultures | 57 s | 34 s | unos 11 s | alrededor del 19% |
Por eso Cycles junkshop (1,31x) escala peor que Cycles classroom (1,59x): aproximadamente la mitad del renderizado de junkshop es trabajo que una segunda tarjeta no puede tocar, mientras que classroom pasa la mayor parte de su tiempo en la parte divisible. Mismo motor, mismo hardware; la escena decide cuánto importa la segunda tarjeta.
También dice algo práctico sobre el hardware más rápido. Una tarjeta más rápida acorta la parte divisible de un renderizado, pero la parte fija se mantiene en un número de segundos aproximadamente igual. Así que cuanto más rápido sea ya su renderizado con una sola tarjeta, mayor será la proporción fija, y menos podrá aportar proporcionalmente una segunda tarjeta. La segunda tarjeta sigue haciendo el renderizado más rápido; simplemente no puede ofrecer un 2x limpio cuando queda poco trabajo lento que dividir. Vale la pena saberlo antes de gastar dinero apilando tarjetas idénticas esperando retornos lineales.
Dos GPUs Es el Límite por Máquina, y Por qué Eso Está Bien
Aquí es donde trazamos una línea firme, porque es la parte que la mayoría del contenido multi-GPU omite discretamente. La máquina de este benchmark tiene dos GPUs, al igual que las demás máquinas GPU de nuestra render farm. Dos tarjetas es el límite por máquina. No le mostraremos una curva de escalado de 4x u 8x en una sola máquina, porque esa no es una configuración que utilicemos, y no vamos a insinuar lo contrario.
Superar las dos GPUs en un único fotograma implica renderizado distribuido multi-nodo: dividir una imagen entre varias máquinas, con toda la coordinación de red, la gestión de bloques o tiles y la sobrecarga que eso implica. Es una arquitectura distinta, no una versión ampliada de una caja de dos tarjetas. No es algo que ofrezcamos hoy para un único fotograma, por lo que no vamos a presentarlo como una función "próximamente" con una fecha adjunta.
Y para la mayor parte del trabajo de producción, el límite de dos GPUs no es la restricción que importa. La restricción que aparece primero es casi siempre la VRAM, no el número de tarjetas: una escena que no cabe en 32 GB no se renderizará independientemente de cuántas GPUs se apunten a ella, lo cual es un problema completamente distinto (lo tratamos en límites de VRAM del RTX 5090 para escenas complejas).
Cómo Escala el Renderizado Más Allá de una Sola Máquina: Fotogramas, no Tarjetas
Esta es la distinción que vale la pena interiorizar. Hay dos cosas completamente distintas que la gente quiere decir con "renderizar más rápido con más hardware":
- Dividir un fotograma entre muchas GPUs o máquinas (renderizado distribuido por tiles o bloques). Esto es lo que miden los números de 1x a 2x a escala de dos tarjetas. Alcanza rápidamente rendimientos decrecientes en los motores de tiempo de renderizado, como muestran los datos, debido a la sobrecarga fija por renderizado, y el coste de coordinación solo crece al añadir máquinas.
- Distribuir muchos fotogramas entre muchas máquinas (renderizado paralelo por fotogramas). Cada máquina renderiza un fotograma completo por su cuenta, y los fotogramas de una animación se reparten en paralelo. No hay sobrecarga de coordinación de un único fotograma que combatir, por lo que esto escala limpiamente.
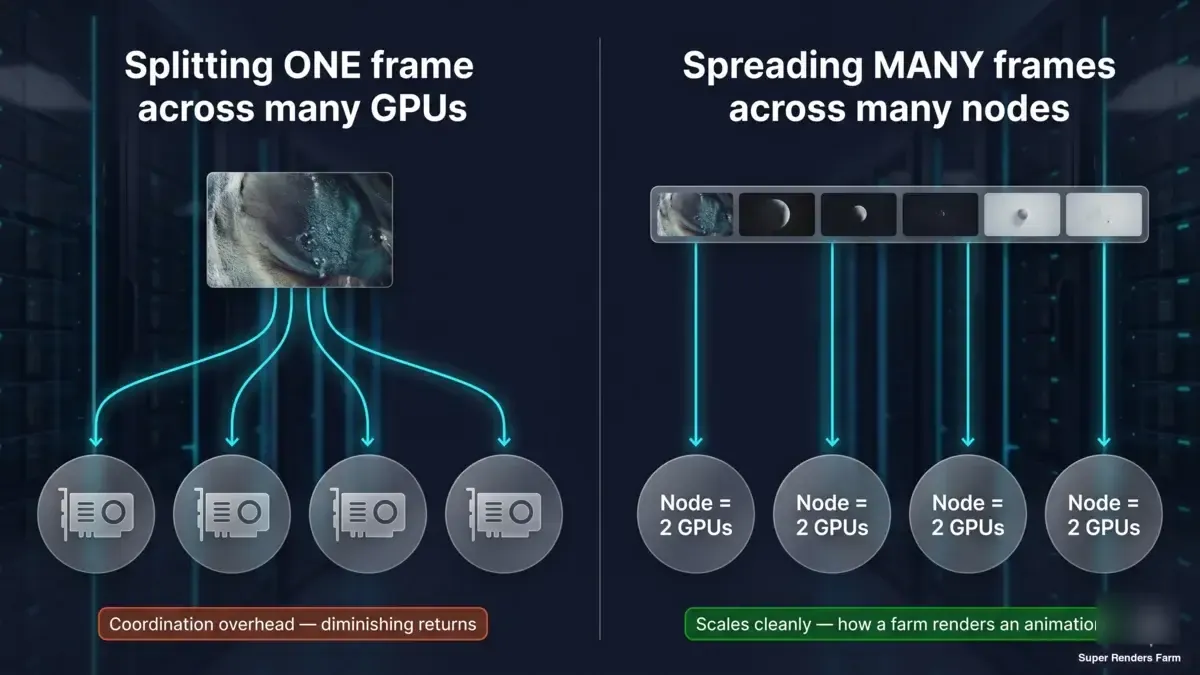 Diagrama conceptual en dos paneles: un fotograma dividido entre varias GPUs choca con la sobrecarga de coordinación y los rendimientos decrecientes; muchos fotogramas completos, cada uno renderizado en su propia máquina en paralelo, escalan limpiamente
En nuestra render farm, las animaciones de CPU se renderizan de esa segunda forma: sus fotogramas se reparten entre muchas máquinas CPU a la vez. Las animaciones de GPU se reparten de la misma forma, entre las tarjetas RTX 5090 que estén libres; nuestra flota de GPU es más pequeña, así que un trabajo de GPU se reparte entre menos máquinas que un trabajo de CPU. Cada fotograma sigue renderizándose a la velocidad por tarjeta y con la sobrecarga de escena medida aquí. La facturación es por hora de tarjeta, por lo que repartir un trabajo cambia sobre todo cuánto tiempo espera; cada tarjeta adicional carga la escena una vez, lo que puede añadir un poco al total en trabajos cortos.
Así que el planteamiento honesto del multi-GPU es más estrecho que la versión de marketing. Dos tarjetas en una máquina le dan un impulso real y medible: cerca de 2x en V-Ray y Octane, más moderado en Cycles y Redshift. Más allá de eso, la respuesta no es "apilar más tarjetas en la caja", sino "ejecutar más fotogramas en más máquinas".
Lo que Esto Significa al Elegir Cómo Renderizar
Si está decidiendo entre una tarjeta y dos para una estación de trabajo, el motor que utiliza habitualmente debería guiar la decisión. Los usuarios de V-Ray u Octane obtienen cerca de un doblaje completo y la segunda tarjeta es fácil de justificar. Los usuarios de Cycles y Redshift deben esperar un aumento de aproximadamente 1,3x a 1,7x en escenas como estas, y deben sopesar si una tarjeta única más rápida es el mejor gasto. Si está decidiendo entre renderizar localmente o encargarlo a una render farm, recuerde que la ventaja de la render farm es el rendimiento paralelo en muchos fotogramas, no un multiplicador mágico de un único fotograma: un único fotograma protagonista fijo no se renderizará dramáticamente más rápido en una render farm que en una estación de trabajo comparable.
Para contexto sobre la compensación entre gestionado y hágalo usted mismo (quién se encarga de los drivers, las licencias y la configuración de los nodos), consulte nuestro análisis de render farm completamente gestionada vs DIY. En nuestra render farm, las licencias del motor de renderizado (V-Ray, Redshift, Octane) están incluidas en la tarifa de renderizado, y la configuración del nodo y los drivers se mantienen por usted, por lo que no son algo que deba ensamblar ni ajustar. Para el lado de Redshift en Cinema 4D específicamente, donde queda la cifra de escalado de 1,68x, consulte nuestra guía de render farm Redshift para Cinema 4D.
Las mediciones aquí son deliberadamente sin exageración. Una segunda GPU es una palanca real con límites reales, los renderizados ganan menos con ella cuanto mayor es la parte de su tiempo que es sobrecarga fija, y la velocidad más allá de una sola máquina es una historia de distribución de fotogramas, no de apilamiento de tarjetas. Saber qué palanca aplica a su carga de trabajo es la mayor parte de la decisión.
Si está calculando el precio de un trabajo a partir de estos multiplicadores, consulte los precios actuales de render farm o lea la metodología de benchmarking de coste por fotograma. Para el lado de CPU de la comparación de hardware, consulte nuestras puntuaciones de Cinebench para cloud rendering o la guía de V-Ray Benchmark. Para el comportamiento de una sola RTX 5090, consulte nuestro análisis de rendimiento del RTX 5090 en cloud rendering de GPU.
FAQ
Q: ¿Añadir una segunda GPU duplica la velocidad de renderizado? A: Por lo general, no. En nuestro benchmark de 2026 en una máquina con dos RTX 5090, los motores de rendimiento como V-Ray y Octane escalaron cerca de 2,00x con una segunda tarjeta idéntica, pero los motores de tiempo de renderizado escalaron menos: Cycles quedó entre 1,31x y 1,59x y Redshift alcanzó 1,68x. La ganancia depende del motor y la escena, porque cada renderizado lleva una sobrecarga fija que una segunda tarjeta no puede acelerar.
Q: ¿Por qué algunos renderizados ganan menos con una segunda GPU que otros? A: Porque parte de cada renderizado es trabajo fijo (análisis de escena, construcción de la estructura de aceleración, calentamiento del kernel) que tarda aproximadamente lo mismo con una tarjeta o con dos. Según nuestros tiempos con una y dos tarjetas, esa parte fija fue de alrededor del 19% en el renderizado Vultures de Redshift y de alrededor del 52% en el renderizado junkshop de Cycles, por lo que junkshop solo escaló 1,31x. Cuanto mayor es esa proporción fija, menos puede aportar la segunda tarjeta.
Q: ¿Por qué V-Ray y Octane escalan mejor que Cycles y Redshift con dos GPUs? A: V-Ray Benchmark y OctaneBench son pruebas de rendimiento donde el coste fijo de configuración es una fracción mínima de la ejecución, por lo que una segunda tarjeta va casi en su totalidad al trabajo útil y el escalado se aproxima a 2,00x. Cycles y Redshift se miden como tiempo total de renderizado, que incluye sobrecarga no paralela que una segunda tarjeta no puede acelerar, por lo que su escalado queda por debajo de 2x.
Q: ¿Puede una render farm hacer que un único fotograma se renderice más rápido en muchas máquinas? A: Dividir un fotograma entre varias máquinas es renderizado distribuido multi-nodo, que es una arquitectura distinta con su propia sobrecarga de coordinación y no es algo que ofrezcamos hoy para un único fotograma. La velocidad de la render farm proviene del renderizado paralelo por fotogramas: muchos fotogramas completos renderizados al mismo tiempo en distintas máquinas, por lo que una animación termina antes mientras que un único fotograma protagonista se renderiza aproximadamente a la velocidad de una sola máquina.
Q: ¿Cuántas GPUs necesito realmente para renderizar? A: Para una sola máquina, dos GPUs es un límite razonable y es lo que usó nuestra máquina de benchmark; más allá de eso, la restricción práctica suele ser la VRAM, no el número de tarjetas, ya que una escena que no cabe en memoria no se renderizará sin importar cuántas tarjetas añada. Si renderiza animaciones, el rendimiento real proviene de ejecutar más fotogramas en más máquinas en lugar de apilar más tarjetas en una sola.
Q: ¿Son estos números de benchmark comparables con las puntuaciones públicas de Blender Open Data? A: No. Ejecutamos Blender Cycles al 200% de resolución, más pesado que el estándar de Open Data, para que cada renderizado dure lo suficiente y produzca un ratio de escalado estable. Eso hace que nuestros tiempos brutos de Cycles sean intencionalmente no comparables con las clasificaciones públicas de Open Data; las escenas fueron ajustadas para medir el escalado, no para igualar las puntuaciones estándar.
Q: ¿Necesito gestionar los drivers y las licencias de GPU para usar una render farm gestionada? A: No. En una render farm completamente gestionada, la configuración del nodo, los drivers y las licencias del motor de renderizado (V-Ray, Redshift, Octane) se gestionan por usted y están incluidos en la tarifa de renderizado, por lo que no son algo que deba ensamblar ni ajustar. Cycles es gratuito y de código abierto, por lo que no lleva licencia aparte.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.