Multi-GPU Scaling: 1 vs 2 GPU Thực Sự Làm Gì Cho Việc Render (Benchmark 2026)
Tổng quan
Giới thiệu
TL;DR: GPU thứ hai hiếm khi làm tốc độ render tăng gấp đôi, và mức độ giúp ích phụ thuộc vào render engine. Trên một máy dual RTX 5090, các benchmark throughput (V-Ray, Octane) scale gần 2,00x, trong khi các engine theo thời gian render scale thấp hơn (Cycles 1,31x đến 1,59x, Redshift 1,68x), vì overhead cố định mỗi lần render ăn vào phần mà card thứ hai có thể tăng tốc. Hai GPU là mức trần thực tế cho một máy; ngoài đó, tốc độ đến từ việc chạy nhiều khung hình hơn trên nhiều máy hơn, không phải từ việc chồng thêm card vào một hộp.
GPU thứ hai không làm cho việc render nhanh gấp đôi. Điều đó nghe có vẻ hiển nhiên khi đã nói ra, nhưng nhiều quyết định phần cứng được đưa ra dựa trên giả định rằng hai card đồng nghĩa với tốc độ gấp đôi. Vào tháng 6 năm 2026, chúng tôi đã lấy một trong các máy dual RTX 5090 của mình và đo lường điều thực sự xảy ra khi chuyển từ một card lên hai card, trên bốn render engine và bảy tổ hợp scene/benchmark.
Tóm gọn: kết quả phụ thuộc vào engine, và vào scene. Các benchmark theo hướng throughput (V-Ray, Octane) scale gần như hoàn hảo, khoảng 2x. Các engine theo thời gian render (Cycles, Redshift) scale thấp hơn, và tỷ trọng overhead cố định trong một lần render càng lớn thì GPU thứ hai càng giúp ích ít hơn. Chúng tôi sẽ đi qua các con số, giải thích tại sao đường cong uốn theo cách đó, và làm rõ giới hạn ở đây. Hai card là mức trần trên một máy đơn. Vượt qua đó là một kiến trúc khác, không phải phiên bản lớn hơn của thiết lập này.
Đây là bài viết về phần cứng/benchmark, vì vậy nó thiên về GPU nhiều. Đáng nói trước rằng GPU chiếm thiểu số trong những gì chạy trên render farm của chúng tôi; phần lớn công việc sản xuất ở đây vẫn là CPU rendering (V-Ray, Corona, Arnold trên CPU). Nhưng khi ai đó hỏi "GPU thứ hai có đáng không," họ xứng đáng được nhận các con số đo lường, không phải một bài chào hàng. Vì vậy, đây là các con số đo lường.
Cách chúng tôi kiểm thử (và những gì các con số này không phải)
Máy test chạy Windows 11 Pro với hai card RTX 5090 trên driver NVIDIA 596.36. Mọi tỷ lệ trong bài viết này so sánh một card với hai card trên cùng một máy, cùng driver và cùng phiên bản phần mềm, vì vậy không có gì khác thay đổi giữa hai lần chạy.
Mọi scene đều là benchmark chuẩn của nhà cung cấp: các scene Open Data của Blender (bmw27, classroom, junkshop), scene "Vultures" của Maxon cho Redshift, Chaos V-Ray Benchmark 6.00.02, và OctaneBench 2025.2.1. Không có dự án khách hàng, không có asset sản xuất. Chúng tôi không công bố thời gian render từng khung hình theo phút, chi phí mỗi khung hình, hay số liệu điện năng ở đây, vì bộ dữ liệu này không chứa chúng và chúng tôi không tự bịa ra.
Một lưu ý về phương pháp ảnh hưởng đến cách bạn đọc các hàng Cycles: chúng tôi chạy Blender Cycles (4.5 LTS, OptiX) ở độ phân giải 200%, nặng hơn mặc định của Open Data, để mỗi lần render kéo dài đủ lâu tạo ra tỷ lệ scaling ổn định. Điều đó có nghĩa là thời gian Cycles thô của chúng tôi không thể so sánh với điểm số Open Data công khai; chúng được điều chỉnh để đo lường scaling, không phải để xếp hạng. Cycles và Redshift được đo bằng thời gian render (giây, thấp hơn là tốt hơn; trung vị của ba lần chạy); V-Ray và Octane được đo bằng điểm số benchmark (vpaths hoặc điểm OctaneBench, cao hơn là tốt hơn). Đó là hai loại chỉ số khác nhau, vì vậy các con số tuyệt đối không bao giờ so sánh xuyên engine. Chỉ tỷ lệ scaling trong cùng engine mới là so sánh công bằng.
Kết quả cốt lõi: Scaling từ 1x lên 2x, theo từng engine
Đây là dữ liệu tiêu đề: GPU RTX 5090 thứ hai giống hệt thực sự mang lại gì cho bạn, theo engine và scene.
| Engine | Scene | 1x RTX 5090 | 2x RTX 5090 | Scaling |
|---|---|---|---|---|
| Cycles | bmw27 | 49,45 s | 32,06 s | 1,54x |
| Cycles | classroom | 23,09 s | 14,54 s | 1,59x |
| Cycles | junkshop | 19,71 s | 15,00 s | 1,31x |
| Redshift | Vultures | 57 s | 34 s | 1,68x |
| V-Ray GPU (CUDA) | benchmark | 11.051 vpaths | 21.728 vpaths | 1,97x |
| V-Ray GPU (RTX) | benchmark | 15.333 vpaths | 30.641 vpaths | 2,00x |
| Octane | OctaneBench suite | 1.690,78 | 3.380,72 | 2,00x |
Đọc từ trên xuống dưới và một sự phân chia rõ ràng xuất hiện. V-Ray và Octane đạt ở mức hoặc ngay dưới 2,00x: GPU thứ hai gần như tăng gấp đôi sản lượng. Cycles nằm trong khoảng 1,31x đến 1,59x. Redshift đạt 1,68x.
Vì vậy, câu hỏi "thêm GPU thứ hai có tăng gấp đôi tốc độ không?" có ba câu trả lời trung thực khác nhau tùy thuộc vào những gì bạn render: về cơ bản là có với V-Ray và Octane, khoảng 1,3x đến 1,6x với Cycles, và ở đâu đó ở giữa với Redshift. Bất kỳ ai nói với bạn rằng một hệ số nhân đơn lẻ bao gồm tất cả việc render đều chưa thực sự đo lường nó.
Tại sao các engine throughput scale tốt hơn các engine render-time
Mô hình này không phải ngẫu nhiên; nó xuất phát từ cách mỗi benchmark sử dụng thời gian. V-Ray Benchmark và OctaneBench là các bài test throughput. Chúng tung một khối lượng công việc lên bất cứ bao nhiêu tài nguyên tính toán có sẵn và báo cáo điểm số, và chi phí thiết lập cố định (tải scene, xây dựng cấu trúc tăng tốc, khởi tạo thiết bị) chỉ là một phần nhỏ trong tổng thời gian chạy. Thêm card thứ hai và hầu hết silicon bổ sung đó đi thẳng vào công việc hữu ích, vì vậy bạn đạt gần 2x. Kết quả V-Ray RTX đạt đúng 2,00x là chính xác những gì bạn sẽ mong đợi từ một khối lượng công việc mà overhead về cơ bản là nhiễu.
Các engine render-time hoạt động khác nhau. Khi bạn đo lường một lần render Cycles hoặc Redshift bằng giây thực tế, bạn đang tính giờ toàn bộ công việc, và mỗi công việc đều mang theo một phần công việc cố định không thể chia cho các card: phân tích scene, xây dựng BVH/cấu trúc tăng tốc, biên dịch kernel và khởi động, phối hợp thiết bị, giải quyết pixel cuối cùng. GPU thứ hai tăng tốc phần thực sự có thể phân chia. Nó không làm gì cho phần cố định. Tổng thời gian render của bạn càng có nhiều overhead cố định, scaling càng nằm xa dưới 2x.
Bao nhiêu phần của mỗi lần render là overhead cố định
Hai mốc thời gian cho mỗi scene cho phép chúng tôi ước tính trực tiếp phần cố định đó. Nếu một lần render mất T1 giây trên một card và T2 giây trên hai card, và chỉ phần có thể phân chia được tăng tốc, thì phần cố định xấp xỉ bằng 2 x T2 trừ T1. Đây là một ước tính hai điểm đơn giản, không phải chỉ số từ profiler, nhưng nó khớp với các con số scaling:
| Scene | 1 card | 2 card | Phần overhead cố định ước tính | Tỷ trọng trong lần render 1 card |
|---|---|---|---|---|
| Cycles junkshop | 19,71 s | 15,00 s | khoảng 10,3 s | khoảng 52% |
| Cycles bmw27 | 49,45 s | 32,06 s | khoảng 14,7 s | khoảng 30% |
| Cycles classroom | 23,09 s | 14,54 s | khoảng 6,0 s | khoảng 26% |
| Redshift Vultures | 57 s | 34 s | khoảng 11 s | khoảng 19% |
Đó là lý do tại sao Cycles junkshop (1,31x) scale kém hơn Cycles classroom (1,59x): khoảng một nửa lần render junkshop là công việc mà card thứ hai không thể chạm tới, trong khi classroom dành phần lớn thời gian ở phần có thể phân chia. Cùng engine, cùng phần cứng; scene quyết định GPU thứ hai quan trọng như thế nào.
Điều này cũng cho bạn biết một điều thực tế về phần cứng nhanh hơn. Một card nhanh hơn rút ngắn phần có thể phân chia của một lần render, nhưng phần cố định vẫn giữ nguyên số giây gần như không đổi. Vì vậy, lần render một card của bạn càng nhanh, tỷ trọng phần cố định càng lớn, và card thứ hai càng đóng góp ít hơn theo tỷ lệ. Card thứ hai vẫn làm cho lần render nhanh hơn; nó chỉ đơn giản là không thể đạt 2x sạch khi còn ít công việc chậm để phân chia. Đây là điều đáng biết trước khi bạn chi tiền chồng các card giống nhau và mong đợi lợi nhuận tuyến tính.
Hai GPU là mức trần mỗi máy, và tại sao điều đó ổn
Đây là nơi chúng tôi vẽ một ranh giới cứng, vì đây là phần mà hầu hết nội dung multi-GPU âm thầm bỏ qua. Máy trong benchmark này có hai GPU, và các máy GPU khác trên render farm của chúng tôi cũng vậy. Hai card là mức trần mỗi máy. Chúng tôi sẽ không cho bạn xem đường cong scaling 4x hoặc 8x trên một máy đơn, vì đó không phải là cấu hình chúng tôi chạy, và chúng tôi sẽ không ngụ ý điều khác.
Vượt quá hai GPU trên một khung hình đơn có nghĩa là kết xuất phân tán đa máy: chia một hình ảnh trên nhiều máy, với tất cả sự phối hợp mạng, quản lý bucket/tile, và overhead mà điều đó kéo theo. Đó là một kiến trúc riêng biệt, không phải phiên bản lớn hơn của một hộp hai card. Đây không phải là điều chúng tôi cung cấp ngày nay cho một khung hình đơn, vì vậy chúng tôi sẽ không treo nó như một tính năng "sắp có" kèm ngày cụ thể.
Và với phần lớn công việc sản xuất, mức trần hai GPU không phải là hạn chế quan trọng nhất. Hạn chế xuất hiện đầu tiên hầu như luôn là VRAM, không phải số lượng card: một scene không vừa trong 32 GB sẽ không render bất kể bạn dùng bao nhiêu GPU, đó là một vấn đề hoàn toàn khác (chúng tôi đề cập đến nó trong bài viết giới hạn VRAM RTX 5090 cho các scene phức tạp).
Cách render mở rộng quy mô ngoài một máy: Khung hình, không phải card
Đây là sự phân biệt đáng ghi nhớ. Có hai điều hoàn toàn khác nhau mà mọi người muốn nói khi nhắc đến "render nhanh hơn trên nhiều phần cứng hơn":
- Chia một khung hình trên nhiều GPU hoặc nhiều máy (kết xuất phân tán tile/bucket). Đây là những gì các con số 1x đến 2x đo lường ở quy mô hai card. Nó đạt lợi nhuận giảm dần nhanh chóng trên các engine render-time, như dữ liệu cho thấy, vì overhead cố định mỗi lần render, và chi phí phối hợp chỉ tăng khi bạn thêm máy.
- Phân phối nhiều khung hình trên nhiều máy (kết xuất song song theo khung hình). Mỗi máy tự render một khung hình đầy đủ, và các khung hình của một hoạt hình được chia song song. Không có overhead phối hợp khung hình đơn để đối phó, vì vậy cách này mở rộng gọn gàng.
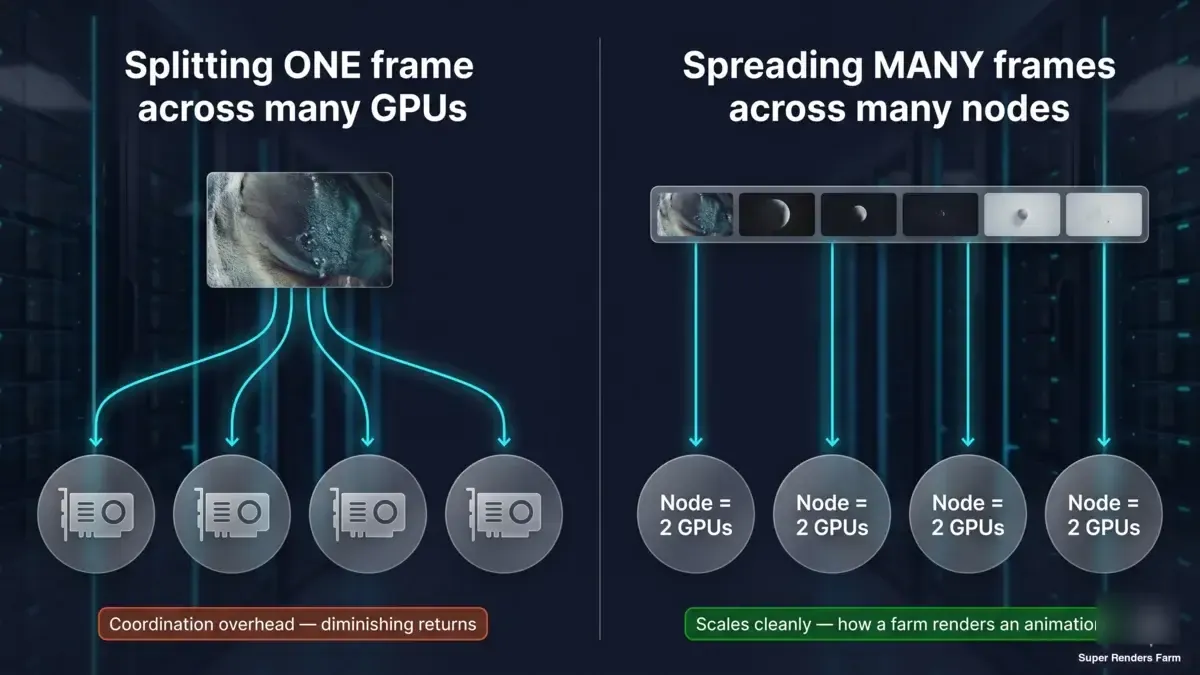 Sơ đồ khái niệm hai phần: một khung hình chia trên nhiều GPU gặp overhead phối hợp và lợi nhuận giảm dần; nhiều khung hình đầy đủ, mỗi khung được render trên máy riêng song song, mở rộng gọn gàng
Trên render farm của chúng tôi, các hoạt hình CPU được render theo cách thứ hai: khung hình của chúng được phân phối trên nhiều máy CPU cùng lúc. Hoạt hình GPU được phân phối theo cùng cách, trên bất kỳ card RTX 5090 nào đang rảnh; GPU fleet của chúng tôi nhỏ hơn, nên một công việc GPU phân phối trên ít máy hơn một công việc CPU. Mỗi khung hình vẫn render ở tốc độ mỗi card và overhead của scene đã đo ở đây. Việc tính phí theo giờ-card, vì vậy việc phân phối một công việc chủ yếu thay đổi thời gian bạn chờ; mỗi card thêm vào sẽ tải scene một lần, điều này có thể cộng thêm một chút vào tổng chi phí trên các công việc ngắn.
Vì vậy, cách nhìn trung thực về multi-GPU hẹp hơn phiên bản marketing. Hai card trong một máy mang lại cho bạn một mức tăng thực sự, có thể đo lường được: gần 2x trên V-Ray và Octane, khiêm tốn hơn trên Cycles và Redshift. Ngoài đó, câu trả lời không phải là "chồng thêm card vào hộp," mà là "chạy thêm khung hình trên nhiều máy hơn."
Điều này có nghĩa gì khi bạn chọn cách render
Nếu bạn đang quyết định giữa một card và hai card cho workstation, engine bạn sử dụng nên là yếu tố quyết định. Người dùng V-Ray hoặc Octane nhận được gần như tăng gấp đôi hoàn toàn và card thứ hai dễ biện minh. Người dùng Cycles và Redshift nên kỳ vọng mức tăng khoảng 1,3x đến 1,7x trên các scene như thế này, và nên cân nhắc liệu một card đơn nhanh hơn có phải là khoản chi tốt hơn không. Nếu bạn đang quyết định render cục bộ hay giao việc cho render farm, hãy nhớ rằng lợi thế của render farm là throughput song song trên nhiều khung hình, không phải một hệ số nhân khung hình đơn thần kỳ: một hero still frame đơn sẽ không render nhanh hơn đáng kể trên render farm so với trên một workstation tương đương.
Để biết bối cảnh về sự đánh đổi quản lý-vs-tự-làm (ai xử lý driver, giấy phép và cấu hình node), bài phân tích render farm quản lý toàn diện vs DIY của chúng tôi đề cập đến nó. Trên render farm của chúng tôi, giấy phép render engine (V-Ray, Redshift, Octane) được bao gồm trong giá render và cấu hình node cùng driver được duy trì cho bạn, vì vậy đó không phải là thứ bạn tự lắp ráp hay điều chỉnh. Cụ thể cho phía Redshift trên Cinema 4D, nơi con số scaling 1,68x rơi vào, hãy xem hướng dẫn render farm Redshift cho Cinema 4D của chúng tôi.
Các phép đo ở đây được cố ý tránh khoa trương. GPU thứ hai là đòn bẩy thực sự với giới hạn thực sự, render được lợi ít hơn từ nó khi tỷ trọng thời gian của chúng là overhead cố định càng lớn, và tốc độ ngoài một máy là câu chuyện phân phối khung hình, không phải chồng card. Biết đòn bẩy nào áp dụng cho khối lượng công việc của bạn là phần lớn của quyết định.
Nếu bạn đang tính giá cho một công việc từ các hệ số này, hãy kiểm tra giá render farm hiện tại hoặc đọc phương pháp benchmark chi phí mỗi khung hình. Về phía so sánh phần cứng CPU, hãy xem điểm số Cinebench cho cloud rendering hoặc hướng dẫn V-Ray Benchmark của chúng tôi. Về hành vi RTX 5090 đơn card, hãy xem bài viết hiệu suất cloud rendering GPU RTX 5090 của chúng tôi.
FAQ
Q: Thêm GPU thứ hai có làm tăng gấp đôi tốc độ render không? A: Thường thì không. Trong benchmark 2026 của chúng tôi trên một máy dual RTX 5090, các engine throughput như V-Ray và Octane scale gần 2,00x với card thứ hai giống hệt, nhưng các engine render-time scale thấp hơn: Cycles đạt từ 1,31x đến 1,59x và Redshift đạt 1,68x. Mức tăng phụ thuộc vào engine và scene, vì mỗi lần render đều mang overhead cố định mà card thứ hai không thể tăng tốc.
Q: Vì sao một số lần render được lợi ít hơn từ GPU thứ hai so với những lần khác? A: Vì một phần của mọi lần render là công việc cố định (phân tích scene, xây dựng cấu trúc tăng tốc, khởi động kernel) mất khoảng cùng một thời gian dù trên một card hay hai card. Từ các mốc thời gian một card và hai card của chúng tôi, phần cố định đó chiếm khoảng 19% lần render Redshift Vultures và khoảng 52% lần render Cycles junkshop, đó là lý do junkshop chỉ scale 1,31x. Tỷ trọng cố định đó càng lớn, GPU thứ hai càng đóng góp được ít hơn.
Q: Vì sao V-Ray và Octane scale tốt hơn Cycles và Redshift trên hai GPU? A: V-Ray Benchmark và OctaneBench là các bài test throughput mà chi phí thiết lập cố định chỉ là một phần nhỏ trong tổng thời gian chạy, vì vậy card thứ hai đi gần như hoàn toàn vào công việc hữu ích và scaling tiệm cận 2,00x. Cycles và Redshift được đo bằng tổng thời gian render, bao gồm overhead không song song được mà card thứ hai không thể tăng tốc, vì vậy scaling của chúng nằm dưới 2x.
Q: Render farm có thể làm cho một khung hình render nhanh hơn trên nhiều máy không? A: Chia một khung hình trên nhiều máy là kết xuất phân tán đa máy, đây là một kiến trúc riêng biệt với overhead phối hợp riêng và không phải là điều chúng tôi cung cấp ngày nay cho một khung hình đơn. Thay vào đó, tốc độ của render farm đến từ kết xuất song song theo khung hình, nhiều khung hình đầy đủ được render cùng lúc trên các máy khác nhau, vì vậy một hoạt hình hoàn thành nhanh hơn trong khi một hero frame đơn render ở tốc độ gần bằng một máy đơn.
Q: Tôi thực sự cần bao nhiêu GPU để render? A: Đối với một máy đơn, hai GPU là mức trần hợp lý và là những gì máy benchmark của chúng tôi sử dụng; ngoài đó, hạn chế thực tế thường là VRAM, không phải số lượng card, vì một scene không vừa trong bộ nhớ sẽ không render dù bạn thêm bao nhiêu card. Nếu bạn render hoạt hình, throughput thực sự đến từ việc chạy nhiều khung hình trên nhiều máy hơn thay vì chồng thêm card vào một máy.
Q: Các con số benchmark này có so sánh được với điểm số Blender Open Data công khai không? A: Không. Chúng tôi chạy Blender Cycles ở độ phân giải 200%, nặng hơn mặc định của Open Data, để mỗi lần render kéo dài đủ lâu tạo ra tỷ lệ scaling ổn định. Điều đó khiến thời gian Cycles thô của chúng tôi cố ý không thể so sánh với bảng xếp hạng Open Data công khai; các scene được điều chỉnh để đo lường scaling, không phải để khớp với điểm số chuẩn.
Q: Tôi có cần quản lý driver GPU và giấy phép để sử dụng render farm được quản lý không? A: Không. Trên một render farm quản lý toàn diện, cấu hình node, driver và giấy phép render engine (V-Ray, Redshift, Octane) đều được xử lý cho bạn và bao gồm trong giá render, vì vậy đó không phải là thứ bạn tự lắp ráp hay điều chỉnh. Cycles miễn phí và mã nguồn mở, vì vậy nó không cần giấy phép riêng.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.