マルチGPUスケーリング検証:1枚と2枚のGPUがレンダリングに与える実際の効果(2026年ベンチマーク)
概要
はじめに
要点: 2枚目のGPUを追加しても、レンダリング速度が2倍になることはほとんどなく、どれだけ効果があるかはレンダリングエンジンによって異なります。デュアルRTX 5090マシンでは、スループット型ベンチマーク(V-Ray、Octane)は2.00倍近くまでスケールした一方、レンダリング時間計測型エンジンはそれを下回りました(Cyclesは1.31倍から1.59倍、Redshiftは1.68倍)。これは、1レンダリングあたりの固定オーバーヘッドが、2枚目のカードが高速化できる部分を侵食するためです。2枚のGPUは1台のマシンにおける実用上の上限であり、それを超える速度向上は、1台の筐体にカードを重ねることではなく、より多くのマシンでより多くのフレームを処理することから生まれます。
2枚目のGPUを追加しても、レンダリングが2倍速くなるわけではありません。口に出してみれば当たり前に聞こえますが、「2枚のカード=2倍の速度」という前提でハードウェアの意思決定が行われるケースは少なくありません。2026年6月、弊社のデュアルRTX 5090マシンの1台を使い、1枚から2枚に増やした際に実際に何が起きるかを、4種類のレンダリングエンジンと7つのシーン/ベンチマークの組み合わせで計測しました。
結論を先に述べると、結果はエンジンと、シーンによって異なります。スループット型のベンチマーク(V-Ray、Octane)はほぼ完璧に、2倍前後までスケールしました。レンダリング時間計測型のエンジン(Cycles、Redshift)はそれを下回り、レンダリングに占める固定オーバーヘッドの割合が大きいほど2枚目のカードの効果は小さくなりました。以下で数値を順に見ていき、なぜそのような曲線を描くのかを説明し、この検証がどこで区切りとなるかも明確にします。2枚のカードがシングルマシンにおける上限です。それを超えるのは別のアーキテクチャの話であり、この構成の拡大版ではありません。
本記事はハードウェア/ベンチマークに特化した内容であるため、GPUの比重が高くなっています。あらかじめお伝えしておくと、GPUは弊社のファームで動く処理の中では少数派であり、大半の本番作業は依然としてCPUレンダリング(CPU上のV-Ray、Corona、Arnold)です。しかし、「2枚目のGPUに価値はあるか」という問いに対しては、セールストークではなく実測値で答えるべきです。以下がその実測値です。
テスト方法(および本データが示さないもの)
テストマシンはWindows 11 Proで稼働し、RTX 5090を2枚搭載、NVIDIAドライバー596.36を使用しました。本記事のすべての比率は、同一マシン上で同一ドライバー・同一ソフトウェアバージョンのまま、1枚のカードと2枚のカードを比較したものであり、2つの計測の間で他の条件は一切変化していません。
各シーンはすべてベンダー標準のベンチマークです。Blenderの Open Dataシーン(bmw27、classroom、junkshop)、MaxonのRedshift用「Vultures」シーン、Chaos V-Ray Benchmark 6.00.02、OctaneBench 2025.2.1を使用しています。顧客のプロジェクトや本番アセットは一切使用していません。フレームあたりの所要時間、フレームあたりのコスト、電力消費量はこのデータセットには含まれておらず、架空の数値を作成することもしないため、本記事では公開しません。
Cyclesの行の読み方に影響する手法上の注意点が一つあります。Blender Cycles(4.5 LTS、OptiX)は、Open Dataのデフォルトより重い200%解像度で実行しました。これは、各レンダリングを安定したスケーリング比率が得られるだけの長さにするためです。そのため、本記事のCycles生データはOpen Dataの公開スコアと比較できるものではなく、リーダーボード用ではなくスケーリング計測用に調整されています。CyclesとRedshiftはレンダリング時間(秒、低いほど良い、3回計測の中央値)で計測し、V-RayとOctaneはベンチマークスコア(vpathsまたはOctaneBenchポイント、高いほど良い)で計測しています。この2つは異なる指標のため、エンジン間の絶対値は決して比較できません。公正に比較できるのは、エンジン内のスケーリング比率のみです。
核心的な結果:エンジン別の1→2倍スケーリング
以下が主要データです。同一のRTX 5090をもう1枚追加することで実際に得られる効果を、エンジンとシーン別に示しています。
| エンジン | シーン | RTX 5090×1 | RTX 5090×2 | スケーリング |
|---|---|---|---|---|
| Cycles | bmw27 | 49.45秒 | 32.06秒 | 1.54倍 |
| Cycles | classroom | 23.09秒 | 14.54秒 | 1.59倍 |
| Cycles | junkshop | 19.71秒 | 15.00秒 | 1.31倍 |
| Redshift | Vultures | 57秒 | 34秒 | 1.68倍 |
| V-Ray GPU (CUDA) | ベンチマーク | 11,051 vpaths | 21,728 vpaths | 1.97倍 |
| V-Ray GPU (RTX) | ベンチマーク | 15,333 vpaths | 30,641 vpaths | 2.00倍 |
| Octane | OctaneBenchスイート | 1,690.78 | 3,380.72 | 2.00倍 |
上から下へ読むと、明確な分かれ目が見えます。V-RayとOctaneは2.00倍かそのすぐ下に着地しており、2枚目のGPUが出力をほぼ倍増させています。Cyclesは1.31倍から1.59倍の間に収まり、Redshiftは1.68倍です。
つまり「2枚目のGPUを追加すれば速度は倍になるか」という問いには、何をレンダリングするかによって3通りの正直な答えがあります。V-RayとOctaneでは基本的にYes、Cyclesではおよそ1.3倍から1.6倍の向上、Redshiftはその中間です。単一の倍率がレンダリング全体に当てはまると言う人は、実際には計測していないということです。
スループット型エンジンがレンダリング時間計測型エンジンより高くスケールする理由
このパターンはランダムではなく、各ベンチマークがどこに時間を費やしているかに起因します。V-Ray BenchmarkとOctaneBenchはスループットテストです。利用可能な計算リソース全体に負荷をかけてスコアを報告する仕組みで、固定のセットアップコスト(シーンの読み込み、アクセラレーション構造の構築、デバイスの初期化)は全体のごくわずかな割合にすぎません。2枚目のカードを追加すると、その追加分のシリコンのほぼすべてが有効な処理にそのまま投入されるため、2倍近い数値が得られます。V-Ray RTXの結果がきれいに2.00倍に達しているのは、オーバーヘッドが実質的にノイズにすぎないワークロードから期待される、まさにその通りの結果です。
レンダリング時間計測型エンジンは異なる挙動を示します。CyclesやRedshiftのレンダリングをウォールクロック秒で計測する場合、ジョブ全体の時間を計っていることになり、すべてのジョブにはカード間で分割できない固定の作業(シーンの解析、BVH/アクセラレーション構造の構築、カーネルのコンパイルとウォームアップ、デバイス間の協調処理、最終的なピクセル解決)が含まれます。2枚目のGPUは実際に分割可能な部分のみを高速化し、固定部分には何の効果もありません。レンダリング時間全体に占める固定オーバーヘッドの割合が大きいほど、スケーリングは2倍から遠ざかります。
各レンダリングに占める固定オーバーヘッドの割合
各シーンにつき2つの計測値があるため、この固定部分を直接推定できます。1枚のカードでT1秒、2枚でT2秒かかり、分割可能な部分のみが高速化すると仮定すると、固定部分はおおよそ「2×T2 − T1」秒になります。これは簡易的な2点推定であり、プロファイラーによる計測ではありませんが、スケーリングの数値と整合しています。
| シーン | 1枚 | 2枚 | 推定固定部分 | 1枚レンダリングに占める割合 |
|---|---|---|---|---|
| Cycles junkshop | 19.71秒 | 15.00秒 | 約10.3秒 | 約52% |
| Cycles bmw27 | 49.45秒 | 32.06秒 | 約14.7秒 | 約30% |
| Cycles classroom | 23.09秒 | 14.54秒 | 約6.0秒 | 約26% |
| Redshift Vultures | 57秒 | 34秒 | 約11秒 | 約19% |
これが、Cycles junkshop(1.31倍)がCycles classroom(1.59倍)よりスケールが低い理由です。junkshopのレンダリングのおよそ半分は2枚目のカードが手を出せない作業である一方、classroomは大部分の時間を分割可能な部分に費やしています。同じエンジン、同じハードウェアであっても、2枚目のカードがどれだけ重要になるかを決めるのはシーンなのです。
これは、より高速なハードウェアについても実践的な示唆を与えてくれます。高速なカードはレンダリングの分割可能な部分を短縮しますが、固定部分はほぼ同じ秒数のまま残ります。つまり、シングルカードのレンダリングがすでに速いほど、固定部分が占める割合は大きくなり、2枚目のカードが比例的に追加できる効果は小さくなります。2枚目のカードはそれでもレンダリングを速くしますが、分割できる重い処理がほとんど残っていない場合、きれいな2倍を実現することはできません。同一のカードを重ねて線形なリターンを期待する前に、これを知っておく価値があります。
2枚のGPUがマシンあたりの上限であり、それで十分な理由
ここで明確な線を引きます。マルチGPUに関するコンテンツの多くが静かに省略している部分だからです。本ベンチマークのマシンはGPUを2枚搭載しており、弊社ファームの他のGPUマシンも同様です。2枚がマシンあたりの上限です。4倍や8倍のシングルマシンスケーリング曲線をお見せすることはありません。そのような構成を弊社では運用しておらず、そう示唆するつもりもないためです。
1フレームにおいて2枚を超えるGPUを使うには、マルチノード分散レンダリングが必要になります。これは、1枚の画像を複数のマシンに分割し、ネットワーク協調処理やバケット/タイル管理とそれに伴うオーバーヘッドを伴う方式です。これは別のアーキテクチャであり、2枚構成の拡大版ではありません。現在、シングルフレームに対してこの機能は提供しておらず、日付付きの「近日公開」機能として提示するつもりもありません。
そして、大半の本番作業においては、2枚という上限は重要な制約ではありません。先に問題となる制約はほとんどの場合、カードの枚数ではなくVRAMです。32 GBに収まらないシーンは、GPUを何枚向けても処理できず、これはまったく別の問題です(RTX 5090の複雑なシーンにおけるVRAM制限で取り上げています)。
1台のマシンを超えたレンダリングのスケール方法:カードではなくフレーム
これは、内面化する価値がある区別です。「より多くのハードウェアでレンダリングを速くする」という表現には、まったく異なる2つの意味があります。
- 1フレームを多数のGPUまたはマシンに分割する(タイル/バケット分散レンダリング)。これが、2枚のカードのスケールで1→2倍の数値が計測しているものです。データが示すとおり、1レンダリングあたりの固定オーバーヘッドのために、レンダリング時間計測型エンジンでは急速に収穫逓減が起こり、マシンを追加するほど協調コストは増加します。
- 多数のフレームを多数のマシンに分散する(フレーム並列レンダリング)。各マシンが独立して完全な1フレームをレンダリングし、アニメーションのフレームが並行して配分されます。シングルフレームの協調オーバーヘッドと戦う必要がないため、きれいにスケールします。
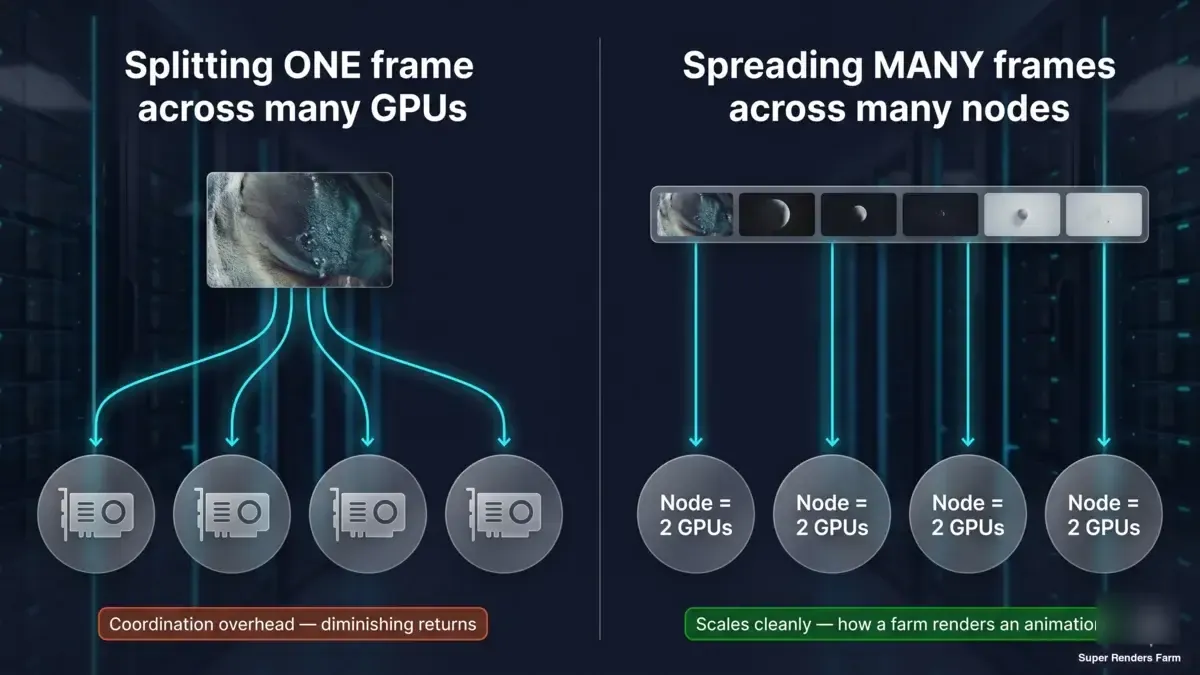 2パネルのコンセプト図:1つのフレームを複数のGPUに分割すると協調オーバーヘッドと収穫逓減が発生する一方、多数の完全なフレームをそれぞれ独自のマシンで並列にレンダリングするときれいにスケールする
弊社のファームでは、CPUアニメーションは後者の方式でレンダリングされています。フレームが多数のCPUマシンに同時に分散される仕組みです。GPUアニメーションも同様の方式で分散され、空いているRTX 5090カードに割り当てられます。GPUフリートはより小規模であるため、GPUジョブが分散される台数はCPUジョブより少なくなります。各フレームは、本記事で計測したカードあたりの速度とシーンのオーバーヘッドで引き続きレンダリングされます。課金はカード時間単位であるため、ジョブを分散させても主に変わるのは待ち時間ですが、カードが増えるたびにシーンの読み込みが1回ずつ発生するため、短いジョブでは合計コストがやや上乗せされることがあります。
つまり、マルチGPUについての正直な見方は、マーケティング上のイメージより狭い範囲に収まります。1台のマシンに2枚のカードを搭載することで、実際に計測可能な向上が得られます。V-RayとOctaneでは2倍近く、CyclesとRedshiftではより控えめです。それを超えると、答えは「筐体にもっとカードを重ねる」ことではなく、「より多くのマシンでより多くのフレームを実行する」ことです。
レンダリング方法を選ぶ際の実践的示唆
ワークステーション用に1枚と2枚のどちらを選ぶか検討している場合、判断を左右すべきは普段使っているエンジンです。V-RayまたはOctaneのユーザーはほぼ完全な倍増が得られるため、2枚目のカードは正当化しやすいでしょう。CyclesとRedshiftのユーザーは、このようなシーンでおよそ1.3倍から1.7倍の向上を見込むべきであり、より高速な1枚のカードの方が良い投資かどうかを検討する価値があります。ローカルでレンダリングするかファームに任せるかを検討している場合は、ファームの強みが多数のフレームにわたる並列スループットであり、シングルフレームを魔法のように高速化する倍率ではないことを覚えておいてください。1枚のヒーロースティルフレームは、同等のワークステーションと比べてファームでも劇的に速くなるわけではありません。
マネージド型とDIY型のトレードオフ(ドライバー、ライセンス、ノード構成を誰が管理するか)については、フルマネージドvs DIYレンダーファームの記事で解説しています。弊社のファームでは、レンダリングエンジンのライセンス(V-Ray、Redshift、Octane)はレンダリング料金に含まれており、ノードの構成とドライバーは弊社側で維持管理されているため、ご自身で組み立てたり調整したりする必要はありません。1.68倍というスケーリング数値が該当するCinema 4D上のRedshiftについては、Cinema 4D向けRedshiftレンダーファームのガイドをご覧ください。
本記事の計測値は、意図的に誇張を排除しています。2枚目のGPUは実際の効果と明確な限界を持つレバーであり、レンダリング時間に占める固定オーバーヘッドの割合が大きいほど得られる恩恵は少なく、1台のマシンを超えた速度向上はカードを重ねる話ではなく、フレームを分散する話です。どのレバーが自分のワークロードに当てはまるかを知ることが、判断の大部分を占めます。
これらの倍率をもとにジョブの費用を見積もる場合は、最新のレンダーファーム料金をご確認いただくか、フレームあたりコストのベンチマーク手法をお読みください。CPU側のハードウェア比較については、クラウドレンダリングにおけるCinebenchスコアまたはV-Ray Benchmarkガイドをご覧ください。シングルカードのRTX 5090の挙動については、RTX 5090 GPUクラウドレンダリングパフォーマンスの記事をご覧ください。
FAQ
Q: 2枚目のGPUを追加するとレンダリング速度は倍になりますか? A: 通常はなりません。デュアルRTX 5090マシンで実施した2026年のベンチマークでは、V-RayやOctaneのようなスループット型エンジンは同一の2枚目のカードで2.00倍近くまでスケールしましたが、レンダリング時間計測型エンジンはそれを下回りました。Cyclesは1.31倍から1.59倍、Redshiftは1.68倍でした。向上幅はエンジンとシーンによって異なります。すべてのレンダリングには、2枚目のカードが速度向上に貢献できない固定オーバーヘッドが含まれているためです。
Q: なぜ一部のレンダリングは、他のレンダリングより2枚目のGPUの恩恵が小さいのですか? A: すべてのレンダリングには、1枚でも2枚でもほぼ同じ時間がかかる固定の作業(シーンの解析、アクセラレーション構造の構築、カーネルのウォームアップ)が含まれているためです。1枚と2枚の計測時間から算出すると、この固定部分はRedshift Vulturesのレンダリングでおよそ19%、Cycles junkshopのレンダリングでおよそ52%を占めており、これがjunkshopのスケーリングが1.31倍にとどまった理由です。この固定部分の割合が大きいほど、2枚目のカードが追加できる効果は小さくなります。
Q: なぜV-RayとOctaneは2枚のGPUでCyclesやRedshiftよりスケールが高いのですか? A: V-Ray BenchmarkとOctaneBenchは、固定のセットアップコストが全体のごくわずかな割合にすぎないスループットテストであるため、2枚目のカードはほぼすべて有効な処理に投入され、スケーリングは2.00倍に近づきます。CyclesとRedshiftは総レンダリング時間として計測され、そこには2枚目のカードが高速化できない非並列のオーバーヘッドが含まれるため、スケーリングは2倍を下回ります。
Q: レンダーファームは1つのフレームを多数のマシンで速くレンダリングできますか? A: 1つのフレームを複数のマシンに分割することはマルチノード分散レンダリングであり、独自の協調オーバーヘッドを持つ別のアーキテクチャです。現在、シングルフレームに対してこの機能は提供していません。ファームの速度は、代わりにフレーム並列レンダリングから生まれます。多数の完全なフレームを異なるマシンで同時にレンダリングする方式であり、そのためアニメーションは高速に完了しますが、単一のヒーローフレームはおおむねシングルマシンの速度でレンダリングされます。
Q: レンダリングには実際に何枚のGPUが必要ですか? A: 1台のマシンにおいては、2枚が妥当な上限であり、弊社のベンチマークマシンもそれを使用しています。それを超えると、実務上の制約は通常カードの枚数ではなくVRAMです。メモリに収まらないシーンは、カードを何枚追加してもレンダリングできません。アニメーションをレンダリングする場合、実際のスループットは、1台のマシンにカードを重ねるよりも、より多くのマシンでより多くのフレームを実行することから得られます。
Q: これらのベンチマーク数値は公開されているBlender Open Dataのスコアと比較できますか? A: いいえ。Blender CyclesをOpen Dataのデフォルトより重い200%解像度で実行しており、各レンダリングは安定したスケーリング比率が得られるだけの長さになっています。そのため、本記事のCycles生データは、意図的に公開のOpen Dataリーダーボードと比較できないものになっています。シーンは標準スコアに合わせるためではなく、スケーリングを計測するために調整されています。
Q: マネージドレンダーファームを利用するにあたり、GPUドライバーやライセンスを自分で管理する必要はありますか? A: いいえ。フルマネージドファームでは、ノードの構成、ドライバー、レンダリングエンジンのライセンス(V-Ray、Redshift、Octane)はすべて弊社側で管理され、レンダリング料金に含まれているため、ご自身で組み立てたり調整したりする必要はありません。Cyclesは無料のオープンソースソフトウェアであるため、別途ライセンスは不要です。
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.