Scaling multi-GPU : ce que font vraiment 1 vs 2 GPU pour le rendu (benchmark 2026)
Aperçu
Introduction
En bref : Une deuxième carte GPU double rarement la vitesse de rendu, et l'ampleur du gain dépend du moteur de rendu. Sur une machine dual RTX 5090, les benchmarks de débit (V-Ray, Octane) ont scalé près de 2,00x, tandis que les moteurs à temps de rendu ont scalé moins bien (Cycles de 1,31x à 1,59x, Redshift 1,68x), car la surcharge opérationnelle fixe par rendu réduit ce que la deuxième carte peut accélérer. Deux GPU constituent un plafond pratique par machine ; au-delà, la vitesse vient du fait de faire tourner plus d'images sur plus de machines, pas d'empiler plus de cartes dans un même boîtier.
Une deuxième carte GPU ne rend pas un projet deux fois plus vite. Cela paraît évident une fois dit, mais de nombreuses décisions d'achat matériel reposent sur l'hypothèse que deux cartes égalent deux fois la vitesse. En juin 2026, nous avons pris l'une de nos machines dual RTX 5090 et mesuré ce qui se passe réellement lorsque l'on passe d'une carte à deux, sur quatre moteurs de rendu et sept combinaisons scène/benchmark.
La version courte : tout dépend du moteur, et de la scène. Les benchmarks en mode débit (V-Ray, Octane) ont scalé de façon quasi parfaite, autour de 2x. Les moteurs à temps de rendu (Cycles, Redshift) ont scalé moins bien, et plus la part d'un rendu qui est de la surcharge fixe est grande, moins la deuxième carte a aidé. Nous allons parcourir les chiffres, expliquer pourquoi la courbe se plie ainsi, et préciser clairement où cela s'arrête. Deux cartes constituent le plafond sur une machine unique. Aller au-delà relève d'une architecture différente, pas d'une version plus grande de celle-ci.
Il s'agit d'un article axé matériel/benchmark, donc orienté GPU. Il convient de préciser d'emblée que le GPU représente une minorité de ce qui tourne sur notre render farm ; la plupart des productions ici utilisent encore le rendu CPU (V-Ray, Corona, Arnold sur CPU). Mais lorsque quelqu'un demande « est-ce qu'une deuxième carte GPU en vaut la peine ? », il mérite des chiffres mesurés, pas un argumentaire commercial. Voici donc les chiffres mesurés.
Comment nous avons testé (et ce que ces chiffres ne sont pas)
La machine de test tournait sous Windows 11 Pro avec deux cartes RTX 5090 sur le pilote NVIDIA 596.36. Chaque ratio de cet article compare une carte à deux cartes sur cette même machine, avec le même pilote et les mêmes versions logicielles, de sorte que rien d'autre ne change entre les deux passages.
Chaque scène est un benchmark standard fournisseur : les scènes Open Data de Blender (bmw27, classroom, junkshop), la scène « Vultures » de Maxon pour Redshift, le Chaos V-Ray Benchmark 6.00.02 et OctaneBench 2025.2.1. Aucun projet client, aucun asset de production. Nous ne publions pas de minutes par image, de coût par image, ni de données électriques ici, car ce jeu de données ne les contient pas et nous ne les inventons pas.
Une note méthodologique qui affecte la lecture des lignes Cycles : nous avons fait tourner Blender Cycles (4.5 LTS, OptiX) à 200 % de résolution, plus lourd que le réglage par défaut Open Data, pour que chaque rendu dure assez longtemps pour produire un ratio de scaling stable. Cela signifie que nos temps bruts Cycles ne sont pas comparables aux scores publics Open Data ; ils sont calibrés pour mesurer le scaling, pas pour figurer dans des classements. Cycles et Redshift sont mesurés en temps de rendu (secondes, moins c'est mieux ; médiane de trois passages) ; V-Ray et Octane sont mesurés en score de benchmark (vpaths ou points OctaneBench, plus c'est mieux). Ce sont deux types de métriques différents, donc les chiffres absolus ne se comparent jamais entre moteurs. Seul le ratio de scaling au sein d'un même moteur est comparable.
Le résultat central : scaling 1x à 2x, par moteur
Voici les données phares : ce qu'une deuxième carte RTX 5090 identique apporte réellement, par moteur et par scène.
| Moteur | Scène | 1x RTX 5090 | 2x RTX 5090 | Scaling |
|---|---|---|---|---|
| Cycles | bmw27 | 49,45 s | 32,06 s | 1,54x |
| Cycles | classroom | 23,09 s | 14,54 s | 1,59x |
| Cycles | junkshop | 19,71 s | 15,00 s | 1,31x |
| Redshift | Vultures | 57 s | 34 s | 1,68x |
| V-Ray GPU (CUDA) | benchmark | 11 051 vpaths | 21 728 vpaths | 1,97x |
| V-Ray GPU (RTX) | benchmark | 15 333 vpaths | 30 641 vpaths | 2,00x |
| Octane | suite OctaneBench | 1 690,78 | 3 380,72 | 2,00x |
Lire ce tableau de haut en bas fait apparaître une nette séparation. V-Ray et Octane arrivent à 2,00x ou juste en dessous : une deuxième carte GPU double presque exactement la production. Cycles se situe entre 1,31x et 1,59x. Redshift atteint 1,68x.
Ainsi, « est-ce qu'ajouter une deuxième carte GPU double ma vitesse ? » a trois réponses honnêtes différentes selon ce que vous rendez : essentiellement oui pour V-Ray et Octane, un gain d'environ 1,3x à 1,6x pour Cycles, et quelque part entre les deux pour Redshift. Quiconque vous affirme qu'un seul multiplicateur s'applique à tout le rendu n'a tout simplement pas mesuré.
Pourquoi les moteurs de débit scalent mieux que les moteurs à temps de rendu
Ce schéma n'est pas aléatoire ; il découle de la façon dont chaque benchmark utilise son temps. V-Ray Benchmark et OctaneBench sont des tests de débit. Ils déversent une charge de travail sur tout le calcul disponible et rapportent un score, et le coût de configuration fixe (chargement de la scène, construction des structures d'accélération, initialisation du périphérique) représente une infime portion du temps total. Ajoutez une deuxième carte et la quasi-totalité de ce silicium supplémentaire va directement en travail utile, ce qui donne un scaling proche de 2x. Le résultat V-Ray RTX atteignant un net 2,00x est exactement ce que l'on attendrait d'une charge de travail où la surcharge opérationnelle est essentiellement du bruit.
Les moteurs à temps de rendu se comportent différemment. Lorsque vous mesurez un rendu Cycles ou Redshift en secondes au mur, vous chronométrez le travail complet, et chaque travail comporte une portion fixe qui ne se divise pas entre les cartes : analyse de la scène, construction BVH/structure d'accélération, compilation du noyau et préchauffage, coordination des périphériques, résolution finale des pixels. Une deuxième carte GPU accélère la partie qui est réellement divisible. Elle ne fait rien pour la partie fixe. Plus votre temps de rendu total est constitué de surcharge opérationnelle fixe, plus votre scaling descend en dessous de 2x.
Quelle part de chaque rendu est de la surcharge fixe
Les deux mesures par scène nous permettent d'estimer directement cette part fixe. Si un rendu prend T1 secondes sur une carte et T2 sur deux, et que seule la partie divisible s'accélère, la part fixe est approximativement 2 x T2 moins T1. C'est une estimation simple à deux points, pas une lecture de profileur, mais elle correspond aux chiffres de scaling :
| Scène | 1 carte | 2 cartes | Part fixe estimée | Part du rendu 1 carte |
|---|---|---|---|---|
| Cycles junkshop | 19,71 s | 15,00 s | environ 10,3 s | environ 52 % |
| Cycles bmw27 | 49,45 s | 32,06 s | environ 14,7 s | environ 30 % |
| Cycles classroom | 23,09 s | 14,54 s | environ 6,0 s | environ 26 % |
| Redshift Vultures | 57 s | 34 s | environ 11 s | environ 19 % |
C'est pourquoi Cycles junkshop (1,31x) scale moins bien que Cycles classroom (1,59x) : environ la moitié du rendu junkshop est un travail qu'une deuxième carte ne peut pas toucher, tandis que classroom passe la majeure partie de son temps dans la partie divisible. Même moteur, même matériel ; c'est la scène qui décide de l'importance de la deuxième carte.
Cela nous apprend aussi quelque chose de pratique sur le matériel plus rapide. Une carte plus rapide raccourcit la partie divisible d'un rendu, mais la partie fixe reste à peu près le même nombre de secondes. Donc plus votre rendu sur une seule carte est déjà rapide, plus la part fixe devient importante, et moins une deuxième carte peut ajouter en proportion. La deuxième carte rend quand même le rendu plus rapide ; elle ne peut simplement pas livrer un 2x net lorsqu'il reste peu de travail lent à diviser. C'est utile à savoir avant de dépenser de l'argent à empiler des cartes identiques en espérant des rendements linéaires.
Deux GPU constituent le plafond par machine, et pourquoi c'est bien
Voici où nous traçons une ligne claire, car c'est la partie que la plupart des contenus multi-GPU passent discrètement sous silence. La machine de ce benchmark comporte deux GPU, tout comme les autres machines GPU de notre render farm. Deux cartes constituent le plafond par machine. Nous n'allons pas vous montrer une courbe de scaling 4x ou 8x sur une seule machine, car ce n'est pas une configuration que nous utilisons, et nous n'allons pas sous-entendre le contraire.
Dépasser deux GPU sur une seule image signifie recourir au rendu distribué multi-nœuds : diviser une image sur plusieurs machines, avec toute la coordination réseau, la gestion des buckets/tuiles et la surcharge opérationnelle que cela implique. C'est une architecture distincte, pas une version plus grande d'un boîtier à deux cartes. Ce n'est pas quelque chose que nous proposons aujourd'hui pour une seule image, donc nous n'allons pas l'agiter comme une fonctionnalité « bientôt disponible » avec une date associée.
Et pour la plupart des productions, le plafond à deux GPU n'est pas la contrainte qui compte. La contrainte qui se manifeste en premier est presque toujours la VRAM, pas le nombre de cartes : une scène qui ne tient pas dans 32 Go ne se rendra pas, quel que soit le nombre de GPU pointés dessus, ce qui est un problème entièrement différent (nous l'abordons dans les limites VRAM du RTX 5090 pour les scènes complexes).
Comment une render farm scale au-delà d'une machine : les images, pas les cartes
C'est la distinction qui mérite d'être intégrée. Il y a deux choses complètement différentes que les gens entendent par « rendre plus vite sur plus de matériel » :
- Diviser une image sur plusieurs GPU ou machines (rendu distribué en tuiles/buckets). C'est ce que les chiffres 1x à 2x mesurent à l'échelle de deux cartes. Cela atteint rapidement des rendements décroissants sur les moteurs à temps de rendu, comme le montrent les données, en raison de la surcharge opérationnelle fixe par rendu, et le coût de coordination ne fait que croître à mesure que l'on ajoute des machines.
- Répartir de nombreuses images sur de nombreuses machines (rendu parallèle par image). Chaque machine rend une image entière par elle-même, et les images d'une animation sont distribuées en parallèle. Il n'y a pas de surcharge de coordination sur une seule image à combattre, donc cela scale proprement.
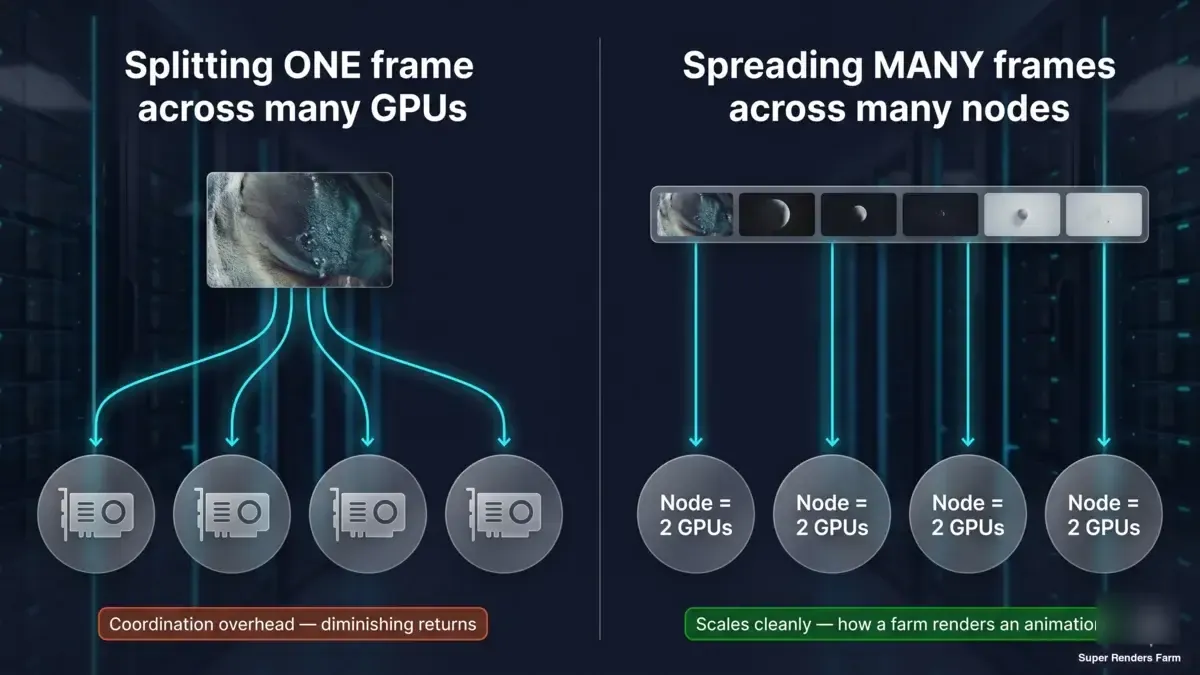 Diagramme conceptuel en deux panneaux : une image divisée sur plusieurs GPU se heurte à une surcharge de coordination et à des rendements décroissants ; de nombreuses images entières, chacune rendue sur sa propre machine en parallèle, scalent proprement
Sur notre render farm, les animations CPU sont rendues selon cette seconde méthode : leurs images sont réparties sur de nombreuses machines CPU à la fois. Les animations GPU sont réparties de la même manière, sur les cartes RTX 5090 disponibles ; notre flotte GPU est plus petite, donc un travail GPU se répartit sur moins de machines qu'un travail CPU. Chaque image se rend toujours à la vitesse par carte et à la surcharge de scène mesurées ici. La facturation est à l'heure-carte, donc répartir un travail change surtout le temps d'attente ; chaque carte supplémentaire charge la scène une fois, ce qui peut ajouter un peu au total sur les travaux courts.
Le cadrage honnête du multi-GPU est donc plus étroit que la version marketing. Deux cartes sur une machine vous apportent un gain réel et mesurable : proche de 2x sur V-Ray et Octane, plus modeste sur Cycles et Redshift. Au-delà, la réponse n'est pas « empiler plus de cartes dans le boîtier », c'est « faire tourner plus d'images sur plus de machines ».
Ce que cela signifie pour choisir votre mode de rendu
Si vous choisissez entre une carte et deux pour une station de travail, le moteur que vous utilisez doit guider la décision. Les utilisateurs de V-Ray ou Octane obtiennent un doublement quasi complet et la deuxième carte est facile à justifier. Les utilisateurs de Cycles et Redshift doivent s'attendre à un gain d'environ 1,3x à 1,7x sur des scènes comme celles-ci, et doivent évaluer si une carte unique plus rapide est la meilleure dépense. Si vous choisissez de rendre localement ou de confier le travail à une render farm, gardez à l'esprit que l'avantage de la render farm est le débit parallèle sur de nombreuses images, pas un multiplicateur magique sur une seule image : une seule image hero fixe ne se rendra pas de façon spectaculairement plus rapide sur une render farm que sur une station de travail comparable.
Pour le contexte sur le compromis entre géré et DIY (qui gère les pilotes, les licences et la configuration des nœuds), notre comparatif render farm entièrement gérée vs DIY le couvre. Sur notre render farm, les licences des moteurs de rendu (V-Ray, Redshift, Octane) sont incluses dans le tarif de rendu, et la configuration des nœuds ainsi que les pilotes sont maintenus pour vous, donc ce n'est pas quelque chose que vous assemblez ou ajustez vous-même. Pour le côté Redshift sur Cinema 4D en particulier, où se situe le chiffre de scaling de 1,68x, consultez notre guide Redshift render farm pour Cinema 4D.
Les mesures présentées ici sont délibérément sans emphase. Une deuxième carte GPU est un vrai levier avec de vraies limites, les rendus en tirent moins à mesure qu'une plus grande part de leur temps est de la surcharge fixe, et la vitesse au-delà d'une seule machine est une question de distribution d'images, pas d'empilement de cartes. Savoir quel levier s'applique à votre charge de travail constitue l'essentiel de la décision.
Si vous chiffrez un travail à partir de ces multiplicateurs, consultez la tarification render farm actuelle ou lisez la méthodologie de benchmark coût par image. Pour le côté CPU de la comparaison matérielle, voir nos scores Cinebench pour le rendu cloud ou le guide V-Ray Benchmark. Pour le comportement d'une seule carte RTX 5090, voir notre article sur les performances de rendu cloud GPU RTX 5090.
FAQ
Q: Est-ce que l'ajout d'une deuxième carte GPU double la vitesse de rendu ? A: Pas généralement. Dans notre benchmark 2026 sur une machine dual RTX 5090, les moteurs de débit comme V-Ray et Octane ont scalé près de 2,00x avec une deuxième carte identique, mais les moteurs à temps de rendu ont scalé moins : Cycles s'est situé entre 1,31x et 1,59x et Redshift a atteint 1,68x. Le gain dépend du moteur et de la scène, car chaque rendu comporte une surcharge opérationnelle fixe qu'une deuxième carte ne peut pas accélérer.
Q: Pourquoi certains rendus gagnent-ils moins d'une deuxième carte GPU que d'autres ? A: Parce qu'une partie de chaque rendu est un travail fixe (analyse de la scène, construction de la structure d'accélération, préchauffage du noyau) qui prend à peu près le même temps sur une ou deux cartes. D'après nos mesures à une et deux cartes, cette part fixe représentait environ 19 % du rendu Redshift Vultures et environ 52 % du rendu Cycles junkshop, ce qui explique pourquoi junkshop n'a scalé qu'à 1,31x. Plus cette part fixe est grande, moins la deuxième carte peut ajouter.
Q: Pourquoi V-Ray et Octane scalent-ils mieux que Cycles et Redshift sur deux GPU ? A: V-Ray Benchmark et OctaneBench sont des tests de débit où le coût de configuration fixe représente une infime fraction du temps d'exécution, donc une deuxième carte va presque entièrement en travail utile et le scaling approche 2,00x. Cycles et Redshift sont mesurés en temps de rendu total, ce qui inclut une surcharge non parallèle qu'une deuxième carte ne peut pas accélérer, donc leur scaling reste en dessous de 2x.
Q: Une render farm peut-elle rendre une seule image plus rapidement sur plusieurs machines ? A: Diviser une image sur plusieurs machines relève du rendu distribué multi-nœuds, une architecture distincte avec sa propre surcharge de coordination, que nous ne proposons pas aujourd'hui pour une seule image. La vitesse d'une render farm vient plutôt du rendu parallèle par image : de nombreuses images entières rendues en même temps sur différentes machines, de sorte qu'une animation se termine plus vite tandis qu'une seule image hero se rend à peu près à la vitesse d'une seule machine.
Q: De combien de GPU ai-je réellement besoin pour le rendu ? A: Pour une seule machine, deux GPU constituent un plafond raisonnable, et c'est ce qu'utilisait notre machine de benchmark ; au-delà, la contrainte pratique est généralement la VRAM, pas le nombre de cartes, puisqu'une scène qui ne tient pas en mémoire ne se rendra pas, quel que soit le nombre de cartes ajoutées. Si vous rendez des animations, le véritable débit vient du fait de faire tourner plus d'images sur plus de machines plutôt que d'empiler plus de cartes dans une seule.
Q: Ces chiffres de benchmark sont-ils comparables aux scores publics Blender Open Data ? A: Non. Nous avons fait tourner Blender Cycles à 200 % de résolution, plus lourd que le réglage par défaut Open Data, pour que chaque rendu dure assez longtemps pour produire un ratio de scaling stable. Cela rend nos temps bruts Cycles intentionnellement non comparables aux classements publics Open Data ; les scènes ont été calibrées pour mesurer le scaling, pas pour correspondre aux scores standard.
Q: Dois-je gérer les pilotes et les licences GPU pour utiliser une render farm gérée ? A: Non. Sur une render farm entièrement gérée, la configuration des nœuds, les pilotes et les licences des moteurs de rendu (V-Ray, Redshift, Octane) sont pris en charge pour vous et inclus dans le tarif de rendu, donc ce n'est pas quelque chose que vous assemblez ou ajustez. Cycles est gratuit et open-source, il ne nécessite donc pas de licence séparée.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.