Çoklu GPU Ölçeklendirmesi: 1 ile 2 GPU Render Hızınızı Gerçekte Ne Kadar Etkiler? (2026 Benchmark)
Genel bakış
Giriş
Özet: İkinci bir GPU render hızını nadiren ikiye katlar; ne kadar yardımcı olduğu render motoruna bağlıdır. Çift RTX 5090'lı bir makinede, aktarım hızı benchmark'ları (V-Ray, Octane) 2,00×'e yakın ölçeklendi; render süresi odaklı motorlar ise daha düşük ölçeklendi (Cycles 1,31× ile 1,59× arası, Redshift 1,68×) çünkü render başına sabit ek yük, ikinci kartın hızlandırabileceği kısmı azaltır. İki GPU, tek bir makine için pratik bir tavandır; bunun ötesinde hız, tek bir kutuya daha fazla kart yığmaktan değil, daha fazla makinede daha fazla kare çalıştırmaktan gelir.
İkinci bir GPU, render'ı iki kat hızlandırmaz. Bu, söylendiğinde açık görünür; ancak pek çok donanım kararı, iki kartın iki kat hız anlamına geldiği varsayımıyla alınmaktadır. Haziran 2026'da, çift RTX 5090'lı makinelerimizden birini aldık ve dört render motoru ile yedi sahne/benchmark kombinasyonunda bir karttan iki karta geçildiğinde gerçekte ne olduğunu ölçtük.
Kısa özet: her şey motora ve sahneye bağlıdır. Aktarım hızı odaklı benchmark'lar (V-Ray, Octane) neredeyse mükemmel biçimde, yaklaşık 2×, ölçeklendi. Render süresi odaklı motorlar (Cycles, Redshift) daha düşük ölçeklendi; bir render'ın sabit ek yük olan payı ne kadar büyükse, ikinci kart o kadar az yardımcı oldu. Sayıları inceleyeceğiz, eğrinin bu şekilde bükülmesinin nedenini açıklayacağız ve bunun nerede durduğunu net biçimde ortaya koyacağız. Tek bir makinede iki kart tavanı oluşturur. Bunun ötesine geçmek, bu mimarinin daha büyük bir versiyonu değil, bambaşka bir mimaridir.
Bu bir donanım/benchmark yazısı olduğu için GPU ağırlıklı bir içerik sunmaktadır. Farm'ımızda çalışan işlerin büyük çoğunluğunun hâlâ CPU rendering (V-Ray, Corona, Arnold CPU üzerinde) olduğunu baştan belirtmek gerekir. Ancak biri "ikinci GPU değer mi?" diye sorduğunda, satış konuşması değil, ölçülmüş sayılar hak edilir. İşte ölçülmüş sayılar.
Nasıl Test Ettik (ve Bu Sayılar Ne Değil)
Test makinesi, NVIDIA sürücü 596.36 ile iki RTX 5090 kartı bulunan Windows 11 Pro üzerinde çalıştı. Bu yazıdaki her oran, aynı makinede, aynı sürücü ve aynı yazılım sürümleriyle bir kartı iki karta karşı karşılaştırır; böylece iki çalıştırma arasında başka hiçbir şey değişmez.
Her sahne bir satıcı standardı benchmark'tır: Blender'ın Open Data sahneleri (bmw27, classroom, junkshop), Redshift için Maxon'ın "Vultures" sahnesi, Chaos V-Ray Benchmark 6.00.02 ve OctaneBench 2025.2.1. Müşteri projeleri veya prodüksiyon dosyaları kullanılmadı. Kare başına dakika, kare başına dolar veya elektrik rakamlarını burada yayımlamıyoruz; çünkü bu veri seti bunları içermiyor ve biz onları uydurmuyoruz.
Cycles satırlarını nasıl okumanız gerektiğini etkileyen bir yöntem notu: Blender Cycles'ı (4.5 LTS, OptiX) %200 çözünürlükte çalıştırdık; bu, Open Data varsayılanından daha ağır bir yüktür, böylece her render stabil bir ölçeklendirme oranı üretecek kadar uzun sürer. Bu, ham Cycles sürelerimizin kamuya açık Open Data puanlarıyla karşılaştırılamaz olduğu anlamına gelir; bunlar liderlik tablosu için değil, ölçeklendirmeyi ölçmek amacıyla ayarlanmıştır. Cycles ve Redshift render süresiyle (saniye, düşük olan daha iyidir; üç çalıştırmanın medyanı) ölçülür; V-Ray ve Octane ise benchmark puanıyla (vpaths veya OctaneBench puanı, yüksek olan daha iyidir) ölçülür. Bu iki farklı metrik türüdür; bu nedenle mutlak sayılar motorlar arasında hiçbir zaman karşılaştırılmaz. Yalnızca bir motor içindeki ölçeklendirme oranı elma ile elma karşılaştırmasıdır.
Temel Sonuç: Motor Bazında 1x'ten 2x'e Ölçeklendirme
İşte manşet veri: ikinci, özdeş bir RTX 5090'ın motor ve sahne bazında gerçekte size ne kazandırdığı.
| Motor | Sahne | 1x RTX 5090 | 2x RTX 5090 | Ölçeklendirme |
|---|---|---|---|---|
| Cycles | bmw27 | 49,45 sn | 32,06 sn | 1,54× |
| Cycles | classroom | 23,09 sn | 14,54 sn | 1,59× |
| Cycles | junkshop | 19,71 sn | 15,00 sn | 1,31× |
| Redshift | Vultures | 57 sn | 34 sn | 1,68× |
| V-Ray GPU (CUDA) | benchmark | 11.051 vpaths | 21.728 vpaths | 1,97× |
| V-Ray GPU (RTX) | benchmark | 15.333 vpaths | 30.641 vpaths | 2,00× |
| Octane | OctaneBench suite | 1.690,78 | 3.380,72 | 2,00× |
Yukarıdan aşağı okunduğunda net bir ayrım ortaya çıkmaktadır. V-Ray ve Octane 2,00×'e eşit ya da biraz altında kalıyor: ikinci bir GPU çıktıyı neredeyse ikiye katlamaktadır. Cycles, 1,31× ile 1,59× arasına yerleşiyor. Redshift ise 1,68×'e ulaşıyor.
Yani "ikinci GPU eklemek hızımı ikiye katlar mı?" sorusunun neye render ettiğinize göre üç farklı dürüst yanıtı vardır: V-Ray ve Octane için temelde evet, Cycles için yaklaşık 1,3× ile 1,6× artış, Redshift için ise ikisi arasında bir değer. Tek bir çarpanın tüm render işlemlerini kapsadığını söyleyen biri bunu gerçekten ölçmemiş demektir.
Aktarım Hızı Odaklı Motorlar Render Süresi Odaklı Motorlardan Neden Daha İyi Ölçeklenir?
Bu örüntü rastgele değildir; her benchmark'ın zamanını nasıl harcadığından kaynaklanmaktadır. V-Ray Benchmark ve OctaneBench, aktarım hızı testleridir. Mevcut hesaplama kapasitesine iş yükü yayarlar ve bir puan raporlarlar; sabit kurulum maliyeti (sahneyi yükleme, hızlanma yapılarını oluşturma, cihazı başlatma) toplam çalışmanın küçük bir dilimidir. İkinci bir kart eklendiğinde bu ek silikonun neredeyse tamamı doğrudan yararlı işe dönüşür; böylece 2×'e yakın bir sonuç elde edilir. V-Ray RTX sonucunun net bir 2,00×'e ulaşması, ek yükün temelde gürültü olduğu bir iş yükünden tam olarak beklenen sonuçtur.
Render süresi odaklı motorlar farklı davranır. Bir Cycles veya Redshift render'ını duvar saati saniyeleriyle ölçtüğünüzde, tüm işi zamanlıyorsunuzdur; ve her işte kartlar arasında bölünmeyen sabit bir iş parçası bulunur: sahne ayrıştırma, BVH/hızlanma yapısı oluşturma, kernel derleme ve ısınma, cihaz koordinasyonu, son piksel çözümü. İkinci GPU, gerçekten bölünebilen kısmı hızlandırır. Sabit kısım için hiçbir şey yapmaz. Toplam render sürenizin ne kadarı sabit ek yükten oluşuyorsa, ölçeklendirmeniz 2×'in o kadar altına düşer.
Her Render'ın Ne Kadarı Sabit Ek Yük?
Sahne başına iki zamanlama, sabit kısmı doğrudan tahmin etmemizi sağlar. Bir render bir kartta T1 saniye, iki kartta T2 saniye sürüyorsa ve yalnızca bölünebilen kısım hızlanıyorsa, sabit kısım kabaca 2 x T2 eksi T1'dir. Bu, bir profiler okuması değil basit bir iki-nokta tahminidir; ancak ölçeklendirme sayılarıyla örtüşmektedir:
| Sahne | 1 kart | 2 kart | Tahmini sabit kısım | 1 kartlı render'ın payı |
|---|---|---|---|---|
| Cycles junkshop | 19,71 sn | 15,00 sn | yaklaşık 10,3 sn | yaklaşık %52 |
| Cycles bmw27 | 49,45 sn | 32,06 sn | yaklaşık 14,7 sn | yaklaşık %30 |
| Cycles classroom | 23,09 sn | 14,54 sn | yaklaşık 6,0 sn | yaklaşık %26 |
| Redshift Vultures | 57 sn | 34 sn | yaklaşık 11 sn | yaklaşık %19 |
Cycles junkshop'un (1,31×) Cycles classroom'dan (1,59×) daha kötü ölçeklenmesinin nedeni budur: junkshop render'ının yaklaşık yarısı ikinci kartın dokunamayacağı bir iştir; classroom ise zamanının büyük bölümünü bölünebilen kısımda geçirir. Aynı motor, aynı donanım; sahne, ikinci kartın ne kadar önemli olduğuna karar verir.
Bu aynı zamanda daha hızlı donanım hakkında pratik bir şey de söyler. Daha hızlı bir kart, render'ın bölünebilen kısmını kısaltır; ancak sabit kısım kabaca aynı saniye sayısında kalır. Yani tek kartlı render'ınız zaten ne kadar hızlıysa, sabit pay o kadar büyür ve ikinci kartın orantılı olarak ekleyebileceği o kadar azalır. İkinci kart yine de render'ı hızlandırır; yalnızca bölünecek yavaş iş çok az kaldığında temiz bir 2× sağlayamaz. Bu, doğrusal getiri bekleyerek özdeş kartları üst üste yığmak için para harcamadan önce bilinmeye değer bir noktadır.
İki GPU Makine Başına Tavandır ve Bu Neden Sorun Değil
Burası net bir çizgi çizmemiz gereken nokta; çünkü çoğu çoklu GPU içeriğinin sessizce atladığı bölüm budur. Bu benchmark'taki makine iki GPU barındırıyor, farm'ımızdaki diğer GPU makineleri de öyle. İki kart, makine başına tavandır. Size 4× ya da 8× tek makine ölçeklendirme eğrisini göstermeyeceğiz; çünkü bu bizim çalıştırdığımız bir yapılandırma değildir ve bunu başka türlü ima etmeyeceğiz.
Tek bir kare üzerinde iki GPU'nun ötesine geçmek, çok node'lu dağıtık rendering anlamına gelir: bir görüntüyü, gerektirdiği tüm ağ koordinasyonu, bucket/tile yönetimi ve ek yükle birlikte birden fazla makineye bölmek. Bu, iki kartlı bir kutunun daha büyük bir versiyonu değil, ayrı bir mimaridir. Bugün tek bir kare için sunduğumuz bir hizmet değildir; bu nedenle bunu tarihli bir "yakında geliyor" özelliği olarak sunmayacağız.
Üretim işlerinin büyük çoğunluğu için ise iki GPU tavanı önemli olan kısıt değildir. İlk baskıyı yapan kısıt neredeyse her zaman kart sayısı değil VRAM'dir: 32 GB'a sığmayan bir sahne, kaç GPU'ya yönlendirilirse yönlendirilsin render edilmez; bu ise tamamen farklı bir sorundur (bunu karmaşık sahneler için RTX 5090 VRAM sınırları yazımızda ele alıyoruz).
Rendering Bir Makinenin Ötesinde Nasıl Ölçeklenir: Kartlar Değil, Kareler
Bu, içselleştirilmeye değer bir ayrımdır. İnsanların "daha fazla donanımda daha hızlı render" derken kastettiği iki tamamen farklı şey vardır:
- Bir kareyi birçok GPU veya makineye bölmek (tile/bucket dağıtık rendering). İki kart ölçeğindeki 1x'ten 2x'e sayılar bunu ölçer. Verinin gösterdiği gibi, sabit render başına ek yük nedeniyle render süresi odaklı motorlarda hızla verim düşüşüyle karşılaşır ve koordinasyon maliyeti yalnızca makine eklendikçe büyür.
- Birçok kareyi birçok makineye yaymak (kare paralel rendering). Her makine tüm kareyi kendi başına render eder ve bir animasyonun kareleri paralel olarak dağıtılır. Savaşılacak tek kare koordinasyon ek yükü yoktur; bu nedenle temiz biçimde ölçeklenir.
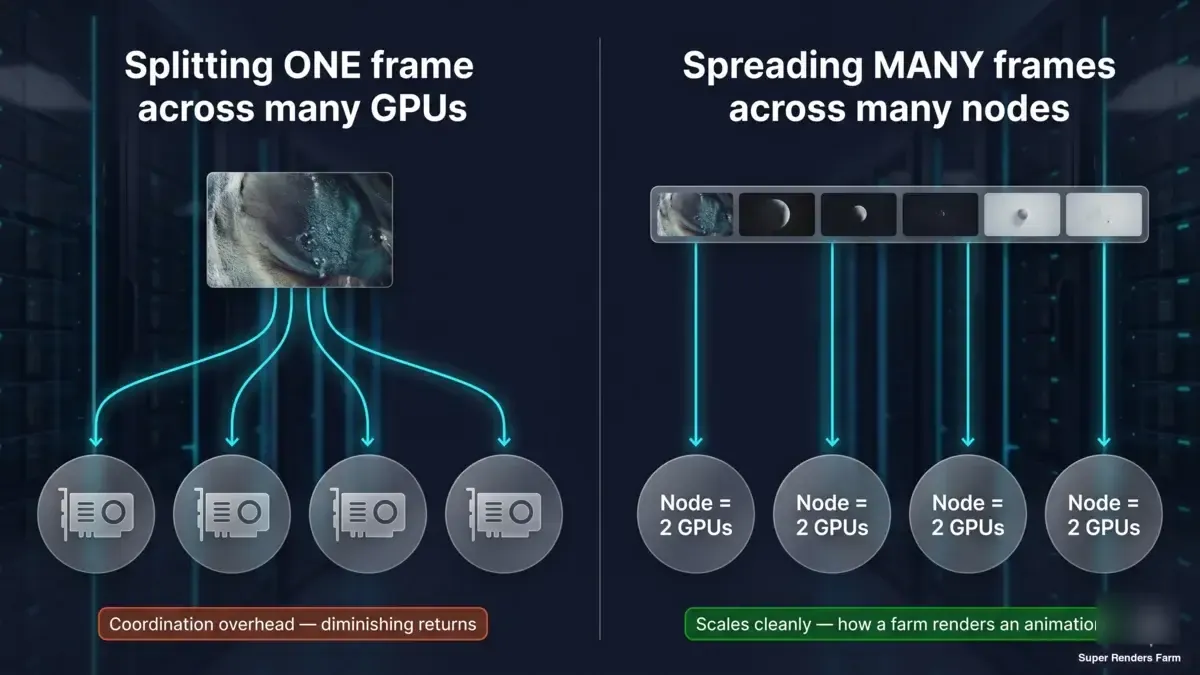 İki bölümlü kavram diyagramı: birden fazla GPU'ya bölünen tek kare koordinasyon ek yüküyle karşılaşır ve verim düşüşü yaşanır; her biri kendi makinesinde paralel olarak render edilen birçok tam kare temiz biçimde ölçeklenir
Farm'ımızda CPU animasyonları ikinci yöntemle render edilir: kareleri aynı anda birçok CPU makinesine yayılır. GPU animasyonları da aynı şekilde, boşta olan RTX 5090 kartlarına yayılır; GPU filomuz daha küçük olduğu için bir GPU işi, bir CPU işine göre daha az makineye yayılır. Her kare yine de burada ölçtüğümüz kart başına hız ve sahne ek yüküyle render edilir. Faturalama kart-saat başınadır, bu nedenle bir işi yaymak esas olarak ne kadar beklediğinizi değiştirir; her ek kart sahneyi bir kez yüklediğinden, kısa işlerde toplam tutara biraz ekleme yapabilir.
Bu nedenle çoklu GPU'nun dürüst çerçevesi, pazarlama versiyonundan daha dardır. Tek bir makinede iki kart size gerçek, ölçülebilir bir artış sağlar: V-Ray ve Octane'de 2×'e yakın, Cycles ve Redshift'te daha mütevazı. Bunun ötesinde yanıt, "kutuya daha fazla kart yığmak" değil, "daha fazla makinede daha fazla kare çalıştırmak"tır.
Render Yönteminizi Seçerken Bu Ne Anlama Geliyor
Bir iş istasyonu için bir kart ile iki kart arasında karar veriyorsanız, kararı kullandığınız motor belirlemelidir. V-Ray veya Octane kullanıcıları neredeyse tam bir ikiye katlamaya ulaşır ve ikinci kart kolayca haklı çıkarılabilir. Cycles ve Redshift kullanıcıları, bu tür sahnelerde yaklaşık 1,3× ile 1,7× artış beklemeli ve daha hızlı tek bir kartın daha iyi bir harcama olup olmadığını değerlendirmelidir. Yerel olarak render yapıp yapmayacağınıza yoksa işi bir farm'a mı devredeceğinize karar veriyorsanız, farm avantajının birçok karede paralel aktarım hızı olduğunu, sihirli bir tek kare çarpanı olmadığını unutmayın: tek bir kahraman sabit kare, karşılaştırılabilir bir iş istasyonuna göre bir farm'da çarpıcı biçimde daha hızlı render edilmeyecektir.
Yönetimli ve kendin-yap ödünleşimi (sürücüleri, lisanslamayı ve node yapılandırmasını kimin üstlendiği) hakkında bağlam için tam yönetimli ve kendin-yap render farm karşılaştırmamıza göz atabilirsiniz. Farm'ımızda render motoru lisanslaması (V-Ray, Redshift, Octane) rendering ücretine dahildir ve node yapılandırması ile sürücüler sizin için sürdürülür; bu nedenle bunları kendiniz kurmanız veya ayarlamanız gerekmez. 1,68× ölçeklendirme rakamının düştüğü Redshift-on-Cinema-4D tarafı için özellikle Cinema 4D için Redshift render farm rehberimize bakabilirsiniz.
Buradaki ölçümler kasıtlı olarak abartısızdır. İkinci GPU, gerçek sınırlara sahip gerçek bir kaldıraçtır; render'lar zamanlarının ne kadar büyük bir bölümü sabit ek yük olursa ondan o kadar az yararlanır ve tek bir makinenin ötesindeki hız, kart istifleme değil bir kare dağıtım hikâyesidir. İş yükünüze hangi kaldıracın uygulandığını bilmek, kararın büyük bölümünü oluşturur.
Bu çarpanlardan bir iş için fiyat çıkarıyorsanız, güncel render farm fiyatlandırmasını kontrol edin veya kare başına maliyet benchmark metodolojisini okuyun. Donanım karşılaştırmasının CPU tarafı için bulut rendering için Cinebench puanları veya V-Ray Benchmark rehberi yazımıza bakabilirsiniz. Tek kart RTX 5090 davranışı için RTX 5090 GPU bulut rendering performansı yazımıza göz atabilirsiniz.
SSS
Q: İkinci bir GPU eklemek render hızını ikiye katlar mı? A: Genellikle hayır. Çift RTX 5090'lı makinede yaptığımız 2026 benchmark'ında, V-Ray ve Octane gibi aktarım hızı odaklı motorlar ikinci özdeş bir kartla 2,00×'e yakın ölçeklendi; ancak render süresi odaklı motorlar daha düşük kaldı: Cycles 1,31× ile 1,59× arasına yerleşti, Redshift ise 1,68×'e ulaştı. Kazanım motora ve sahneye bağlıdır; çünkü her render, ikinci kartın hızlandıramadığı sabit bir ek yük taşır.
Q: Bazı render'lar neden ikinci bir GPU'dan diğerlerinden daha az yararlanır? A: Çünkü her render'ın bir kısmı, bir kartta da iki kartta da yaklaşık aynı sürede tamamlanan sabit bir iştir (sahne ayrıştırma, hızlanma yapısı oluşturma, kernel ısınması). Bir kart ve iki kart zamanlamalarımıza göre, bu sabit kısım Redshift Vultures render'ının yaklaşık %19'unu, Cycles junkshop render'ının ise yaklaşık %52'sini oluşturuyordu; junkshop'un yalnızca 1,31× ölçeklenmesinin nedeni budur. Bu sabit pay ne kadar büyükse, ikinci kartın ekleyebileceği o kadar azalır.
Q: V-Ray ve Octane, iki GPU genelinde neden Cycles ve Redshift'ten daha iyi ölçeklenir? A: V-Ray Benchmark ve OctaneBench, sabit kurulum maliyetinin çalışmanın küçük bir bölümü olduğu aktarım hızı testleridir; bu nedenle ikinci kart neredeyse tamamen yararlı işe gider ve ölçeklendirme 2,00×'e yaklaşır. Cycles ve Redshift, ikinci kartın hızlandıramadığı paralel olmayan ek yükü içeren toplam render süresi olarak ölçülür; bu nedenle ölçeklendirmeleri 2×'in altında kalır.
Q: Bir render farm, tek bir kareyi birçok makinede daha hızlı render edebilir mi? A: Tek bir kareyi birden fazla makineye bölmek çok node'lu dağıtık rendering'dir; bu, kendi koordinasyon ek yüküne sahip ayrı bir mimaridir ve bugün tek bir kare için sunduğumuz bir hizmet değildir. Farm hızı bunun yerine kare paralel rendering'den gelir: farklı makinelerde aynı anda render edilen birçok tam kare; bu nedenle bir animasyon daha hızlı tamamlanırken tek bir kahraman kare, yaklaşık tek makine hızında render edilir.
Q: Rendering için gerçekte kaç GPU'ya ihtiyacım var? A: Tek bir makine için iki GPU makul bir tavandır ve benchmark makinemiz de bunu kullandı; bunun ötesinde pratik kısıt genellikle kart sayısı değil VRAM'dir, çünkü belleğe sığmayan bir sahne kaç kart eklerseniz ekleyin render edilmez. Animasyon render ediyorsanız, gerçek aktarım hızı bir kutuya daha fazla kart yığmaktan değil, daha fazla makinede daha fazla kare çalıştırmaktan gelir.
Q: Bu benchmark sayıları kamuya açık Blender Open Data puanlarıyla karşılaştırılabilir mi? A: Hayır. Blender Cycles'ı, Open Data varsayılanından daha ağır olan %200 çözünürlükte çalıştırdık; böylece her render, stabil bir ölçeklendirme oranı üretecek kadar uzun sürdü. Bu, ham Cycles sürelerimizi kamuya açık Open Data liderlik tablolarıyla kasıtlı olarak karşılaştırılamaz kılar; sahneler standart puanlarla eşleşmek için değil, ölçeklendirmeyi ölçmek amacıyla ayarlandı.
Q: Yönetimli bir render farm kullanmak için GPU sürücülerini ve lisansları yönetmem gerekir mi? A: Hayır. Tam yönetimli bir farm'da node yapılandırması, sürücüler ve render motoru lisanslaması (V-Ray, Redshift, Octane) sizin için yönetilir ve rendering ücretine dahildir; bu nedenle bunları kurmanız veya ayarlamanız gerekmez. Cycles ücretsiz ve açık kaynaklıdır, bu nedenle ayrı bir lisans gerektirmez.
About Thierry Marc
3D Rendering Expert with over 10 years of experience in the industry. Specialized in Maya, Arnold, and high-end technical workflows for film and advertising.